GPT Image 2.5 Flare 與 Sunburst 比較:23 次生成看到了什麼
Flare 和 Sunburst 在所有可比較的品質等級中,token 用量完全相同,因此費用也一樣。我們實測了速度與生成結果,看看兩者差在哪裡。
以 Markdown 閱讀先說結果:Flare 與 Sunburst 的費用相同,因為在所有可比較的品質等級中,兩者計費的 token 數完全一致。在按 token 計費的通道上,Sunburst 每次都比較慢。四組提示詞的畫質比較,我們選不出贏家。OpenAI 對 Sunburst 的主要訴求是編輯精準度,而這恰好是本輪沒測的項目。因此,平常先用 Flare,需要編輯時再用 Sunburst,是合理的選擇。
以下數據來自 2026 年 11 月 2 日在 TokLab 完成的 23 次生成,另外還有一次失敗的 Sunburst 生成。每組設定只跑一次,請將它們視為觀察紀錄,而非效能評測。
Flare 與 Sunburst 的 token 用量相同
OpenAI 對兩款模型採用相同定價:文字輸入每百萬 token $5、影像輸入每百萬 token $8、影像輸出每百萬 token $30;Batch API 的輸出費率為每百萬 token $15(OpenAI 價格,查核日期為 2026 年 11 月 2 日)。當時還不確定的是,同一張圖,Sunburst 是否會用掉更多 token。結果並沒有。
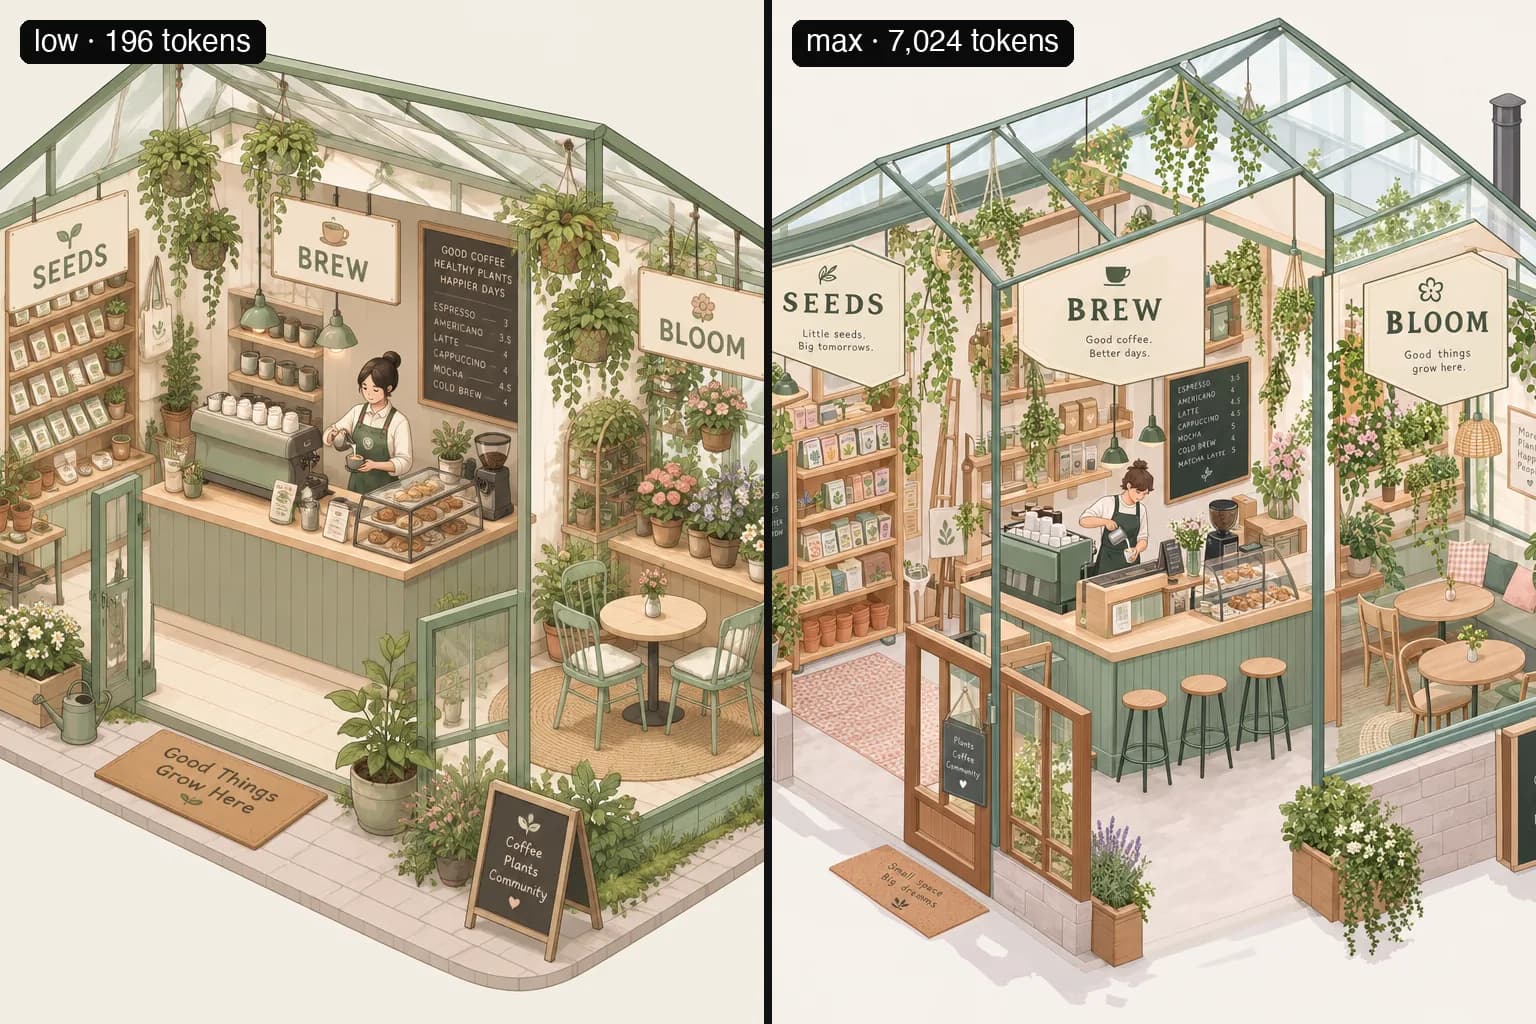
我們使用同一段提示詞,要求生成具有三個標示區域的等角視角溫室咖啡館,以 1024×1024 尺寸,在兩款模型上逐一測試各品質等級:
| 品質 | Flare 輸出 token | Sunburst 輸出 token |
|---|---|---|
| low | 196 | 196 |
| medium | 439 | 439 |
| high | 1,756 | 1,756 |
| xhigh | 3,122 | 3,122 |
| max | 7,024 | 無數據(生成失敗) |
從 low 到 xhigh,數量完全相同;Sunburst 的 max 生成失敗,因此這一列無法成對比較。兩款模型回報的提示詞文字輸入用量都是 50 token。相同 token 數乘上相同費率,費用自然相同,因此不必用價格來決定選哪款。各品質等級的費用計算,請見 GPT Image 2.5 API 價格。
Sunburst 在哪個通道比較慢?
以下時間單位為秒,取自任務回報的建立到完成時間,包含我們處理流程中的排隊時間。因此請看兩者差距,不宜直接把絕對數值當成模型速度。
在 -official ID 上,使用相同的咖啡館提示詞,尺寸為 1024×1024:
| 品質 | Flare | Sunburst |
|---|---|---|
| low | 43 | 47 |
| medium | 42 | 63 |
| high | 47 | 63 |
| xhigh | 59 | 81 |
| max | 83 | 424 秒後失敗 |
Sunburst 在每個等級都比較慢,從 medium 起慢了 16 到 22 秒。失敗的 max 生成沒有回傳影像,帳本也顯示未扣款,符合 TokLab 失敗任務不計費的規則。
按張計費的 Standard ID 則是另一種情況。在 high 與 max 的七組 Flare/Sunburst 配對中,Flare 三次先完成,Sunburst 四次先完成;兩邊各有一次明顯領先(咖啡館 high:42 秒對 59 秒;海報 max:64 秒對 39 秒)。就算 Flare 在這個通道有速度優勢,每組設定只跑一次,也還看不出來。
四組提示詞,直接比較生成結果
以下都是未經修改的原始輸出,標籤註明模型與品質。
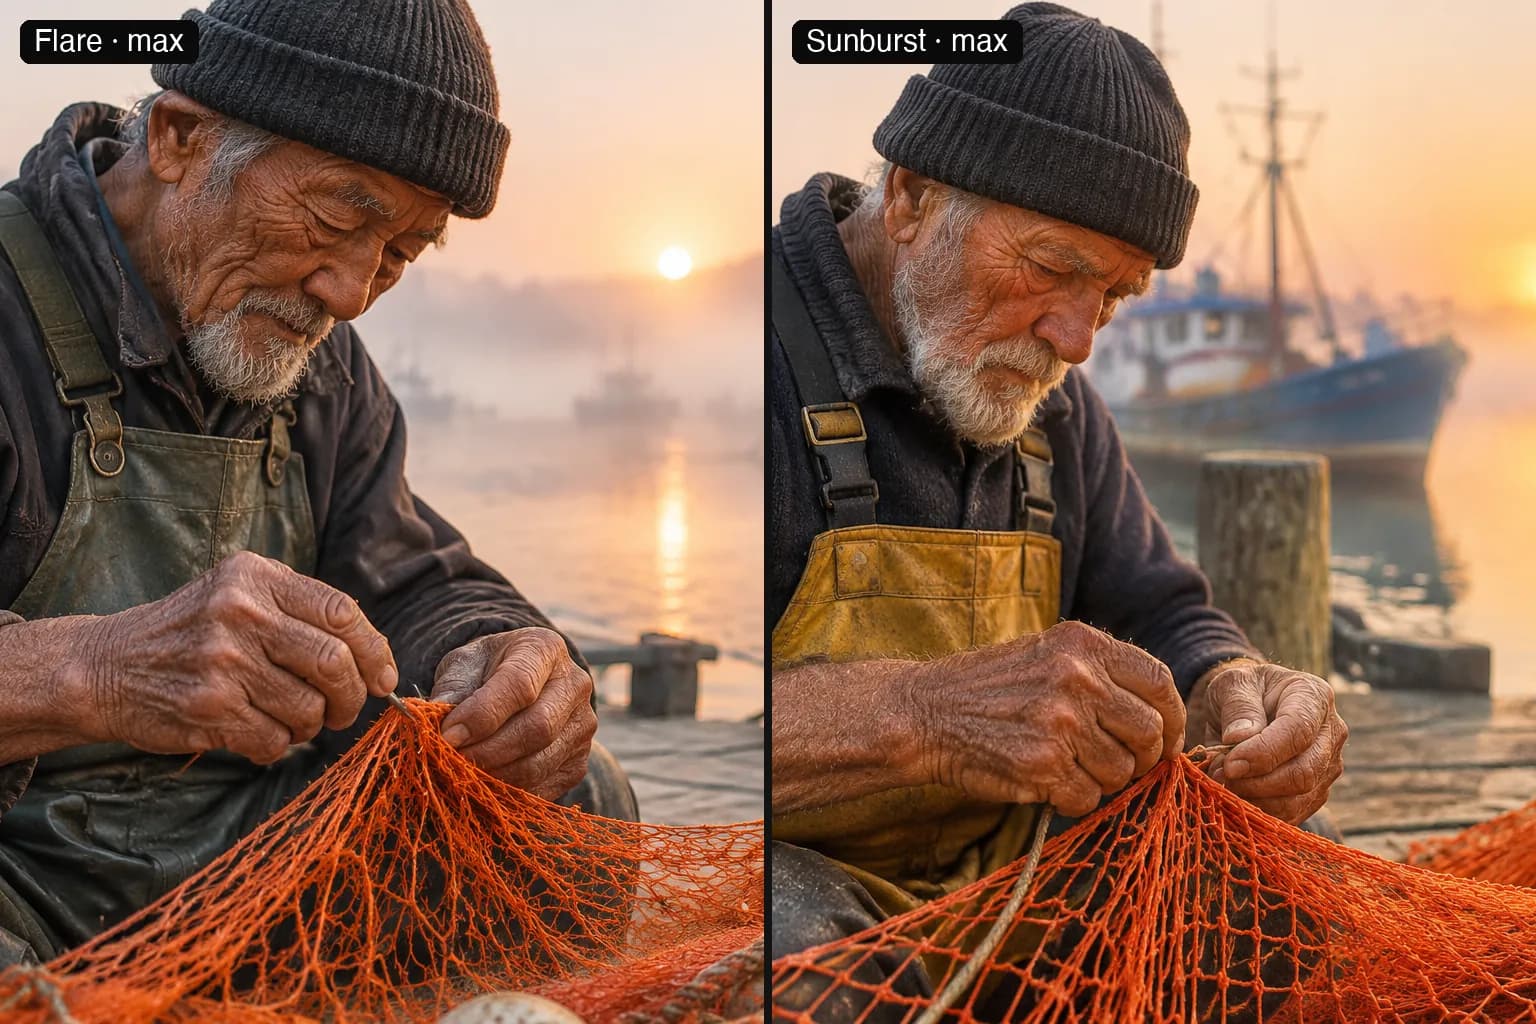
漁夫提示詞要求晨霧、橘色漁網,以及清晰對焦的雙手。兩款都做到了,但選了不同的人物、船隻與光線。Flare 的霧較濃,Sunburst 則加入燈塔與更強的陽光。兩者都沒有過去那種一看就露餡的扭曲手指。
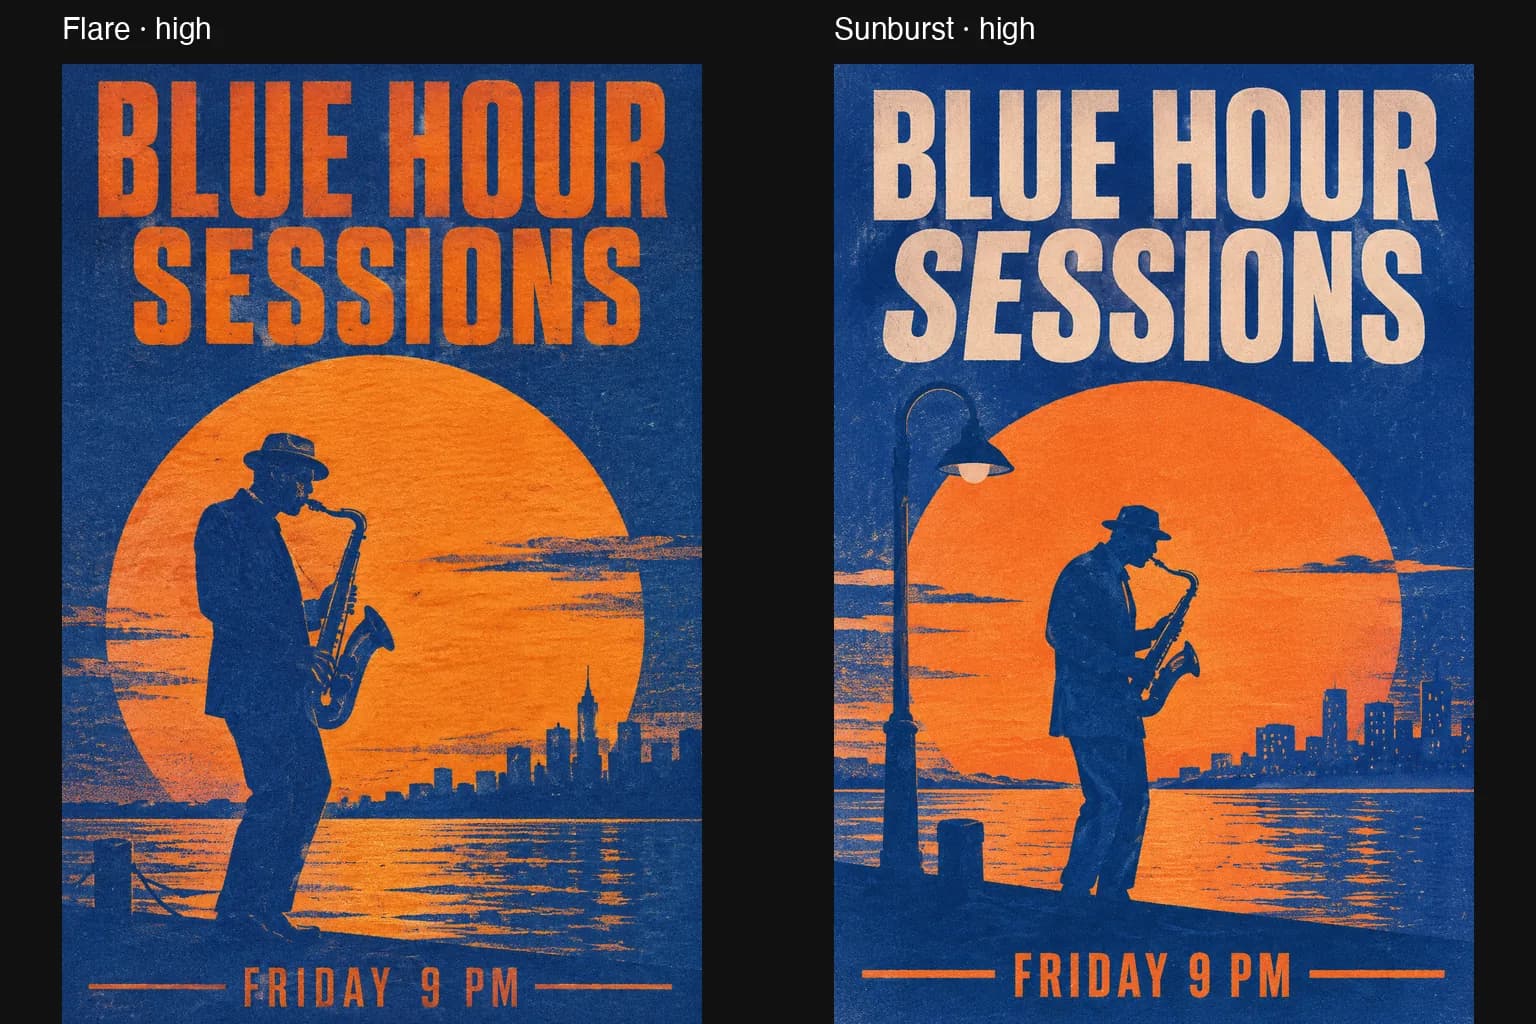
海報測的是文字。兩者都正確拼出 BLUE HOUR SESSIONS 與 FRIDAY 9 PM,維持雙色印刷,並依要求將 FRIDAY 9 PM 以窄體字排在底部。Sunburst 多放了一盞提示詞沒要求的路燈。這是喜好問題,算不上錯誤。
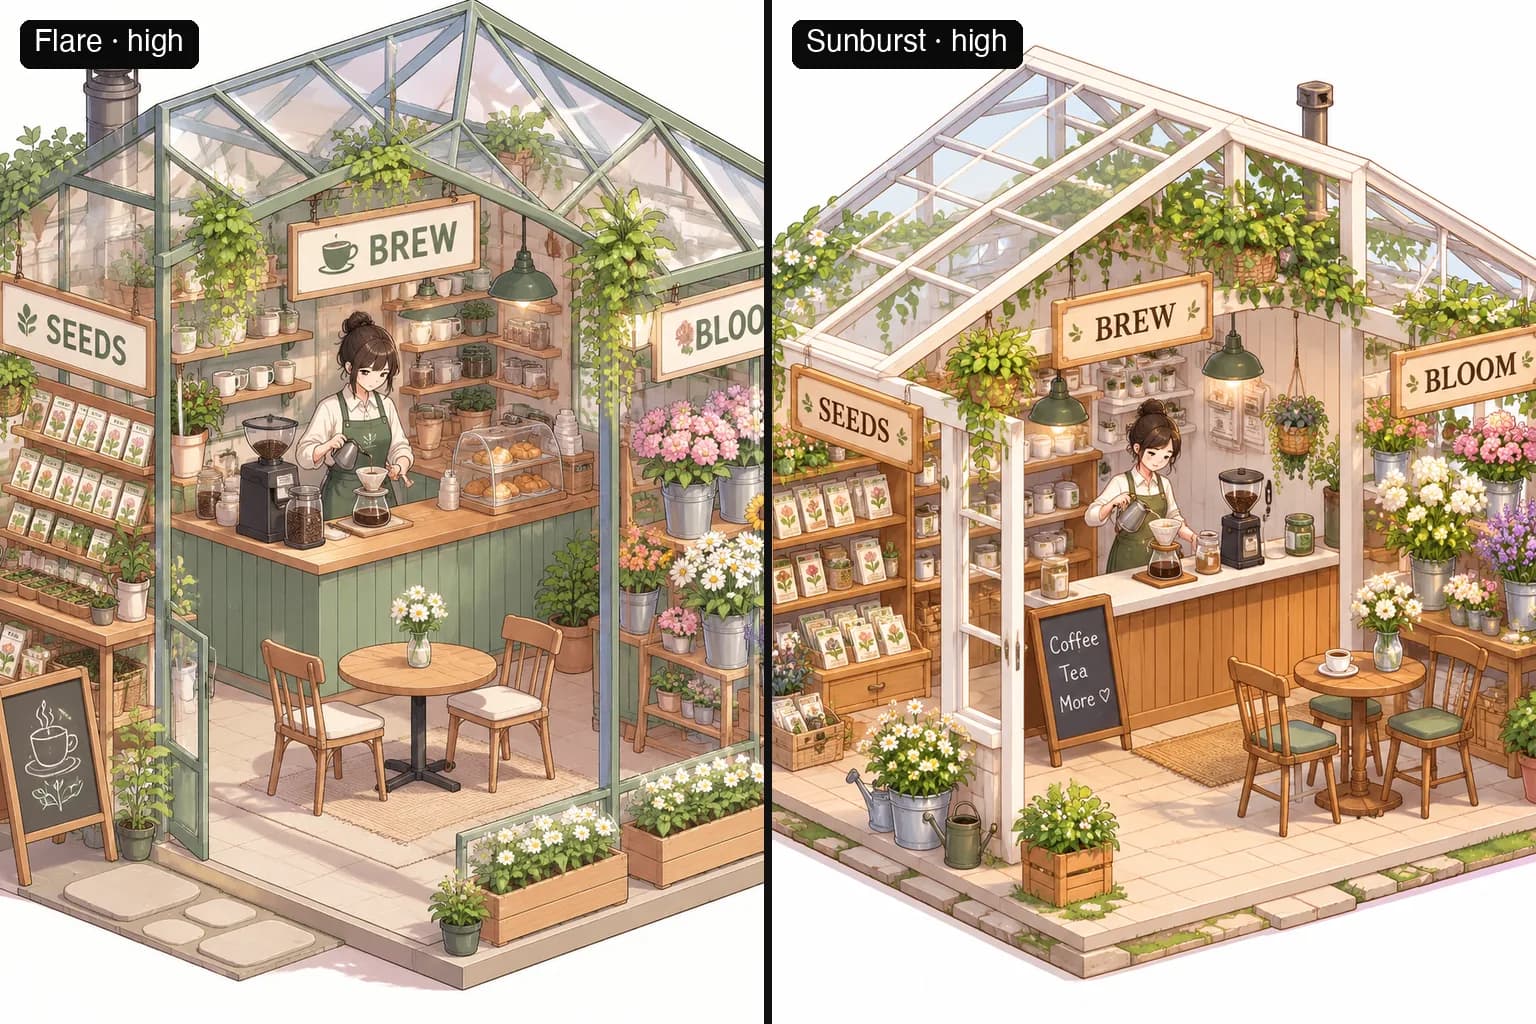
三個指定標示,兩者都寫對了,也都自行加上其他招牌與可讀的飲料菜單。Sunburst 的建築線條較硬朗,建築感更強;Flare 則較柔和。兩張圖額外生成的小字,在公開使用前都該校對。
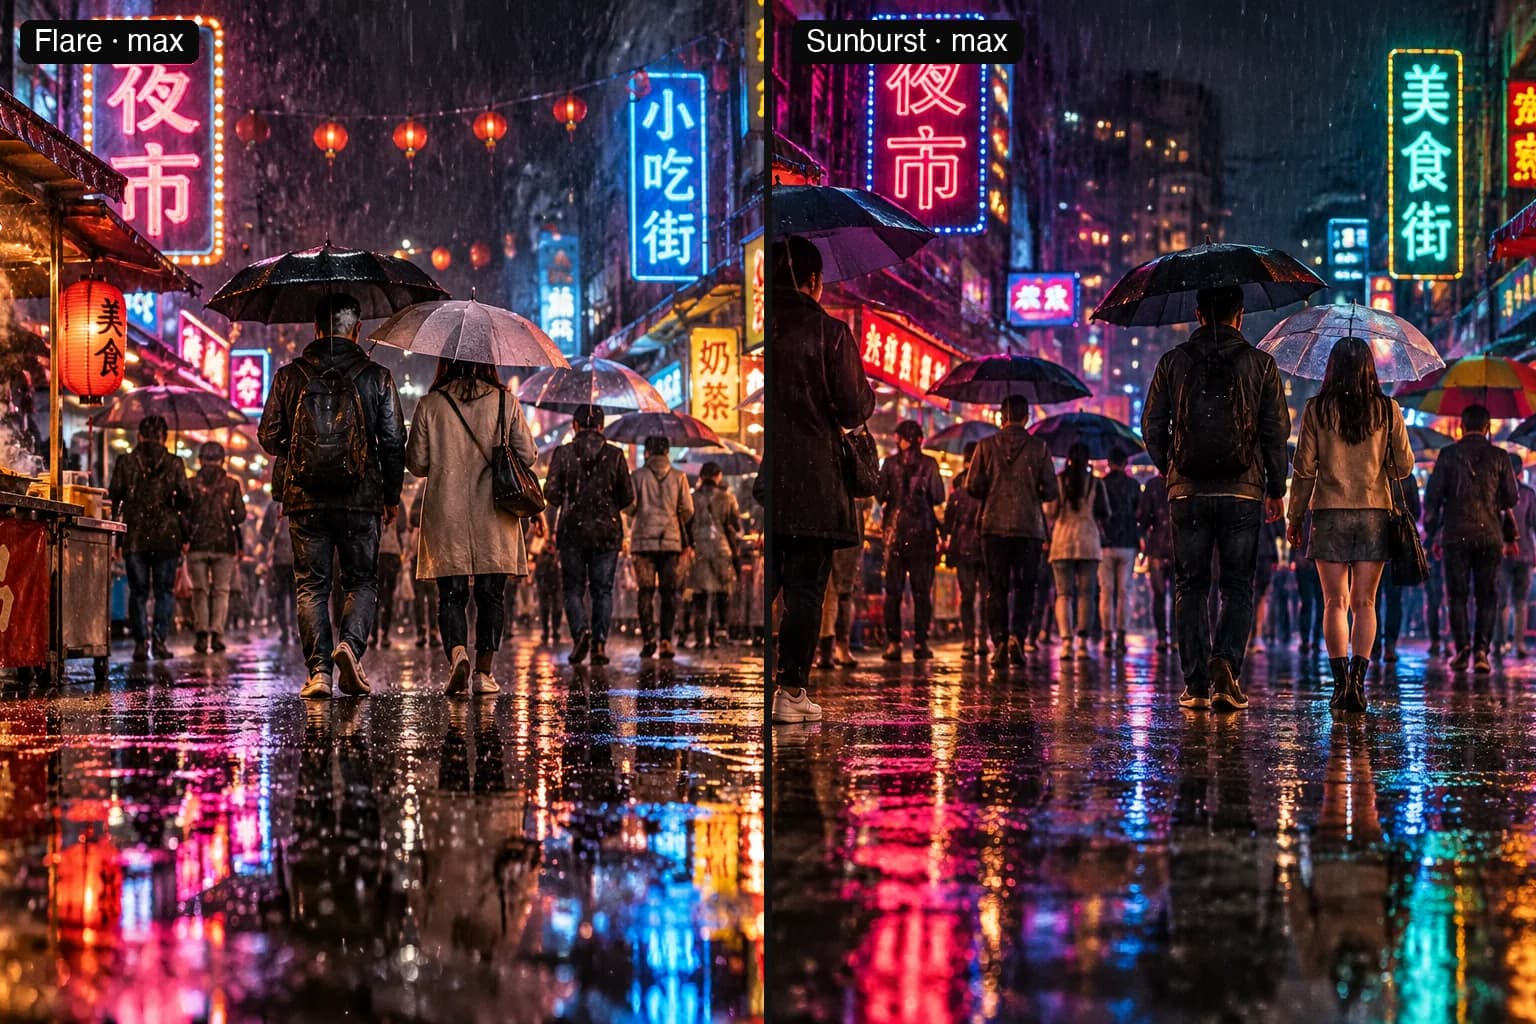
夜市提示詞沒有指定語言或城市,兩款模型都自行選用中文招牌。我們檢查過的文字,如「夜市」、「烤串」、「臭豆腐」等,都是實際使用的詞,意思也正確。Flare 的倒影較繁複;Sunburst 的街道較乾淨,光線也更均勻。
兩者差在風格,沒有誰比較正確。如果其中一種畫面更適合你的產品,這就是足夠的選擇理由,反正費用相同。
這輪測試還缺了什麼?
最大的缺口是編輯。OpenAI 將 Sunburst 定位為「最重視編輯精準度的工作流程」所用的模型,並稱 Flare 是其「日常高品質影像生成速度最快的模型」(模型頁面)。我們原本規劃了三輪編輯測試,但這一輪先刪去了,因此手上沒有能支持或否定這項說法的實測證據。如果你的產品主要用來編輯影像,決定之前,請拿自己的參考圖在兩款模型上都試過。
還有兩個較小的缺口:所有 token 數都來自 1024×1024,畫布放大會用掉更多 token;而所有時間都只量過一次。
怎麼知道用的是 Flare 還是 Sunburst?
YouTube 留言串裡有人問:「那我們要怎麼知道自己用的是 Sunburst 還是 Flare 啊?」透過 API 就不用猜。你用 ID 指定模型,系統不會自行替換;任務完成後也會回報實際使用的模型:
{ "id": "task_...", "model": "gpt-image-2.5-sunburst", "status": "completed" }用量紀錄也會列出每個任務的模型與扣款。
程式裡該填哪個模型 ID?
在 TokLab,每款模型都有按張收取固定費用的 Standard ID,以及按 token 計費的 -official ID:
gpt-image-2.5-flare與gpt-image-2.5-sunburstgpt-image-2.5-flare-official與gpt-image-2.5-sunburst-official
四者的請求主體完全相同,切換時只需改一個字。我們的選擇是:先用 gpt-image-2.5-flare,以 low 品質反覆試稿。需要編輯,而且自己的測試顯示 Sunburst 能保留更多原圖內容時,再把作業轉過去。GPT Image 2.5 Playground 可用自己的餘額執行兩款模型,欄位與 API 相同;完整參數清單則見 API 參考文件。