GPT Image 2.5 Flare ou Sunburst : notre bilan après 23 rendus
Flare et Sunburst consomment autant de tokens aux niveaux comparés, donc coûtent le même prix. Nos mesures de vitesse et notre comparaison des images.
Lire en MarkdownFlare et Sunburst coûtent le même prix : ils ont facturé exactement le même nombre de tokens à chaque niveau de qualité que nous avons pu comparer. Sur le canal facturé au token, Sunburst était plus lent à chaque essai. Sur quatre prompts, impossible de départager les images en termes de qualité. OpenAI met en avant la précision des retouches de Sunburst, et c’est justement ce que nous n’avons pas testé ici. Flare est donc le choix raisonnable par défaut ; réservez Sunburst aux retouches.
Les chiffres ci-dessous proviennent de 23 rendus terminés sur TokLab le 2 novembre 2026, auxquels s’ajoute un rendu Sunburst en échec. Nous n’avons lancé chaque configuration qu’une fois. Ce sont des observations, pas un banc d’essai.
Flare et Sunburst facturent autant de tokens
OpenAI applique les mêmes tarifs aux deux modèles : $5 par million de tokens d’entrée texte, $8 par million de tokens d’entrée image et $30 par million de tokens de sortie image, avec une sortie à $15 via la Batch API (tarifs OpenAI, vérifiés le 2 novembre 2026). Restait à savoir si Sunburst consommait plus de tokens pour la même image. Ce n’est pas le cas.
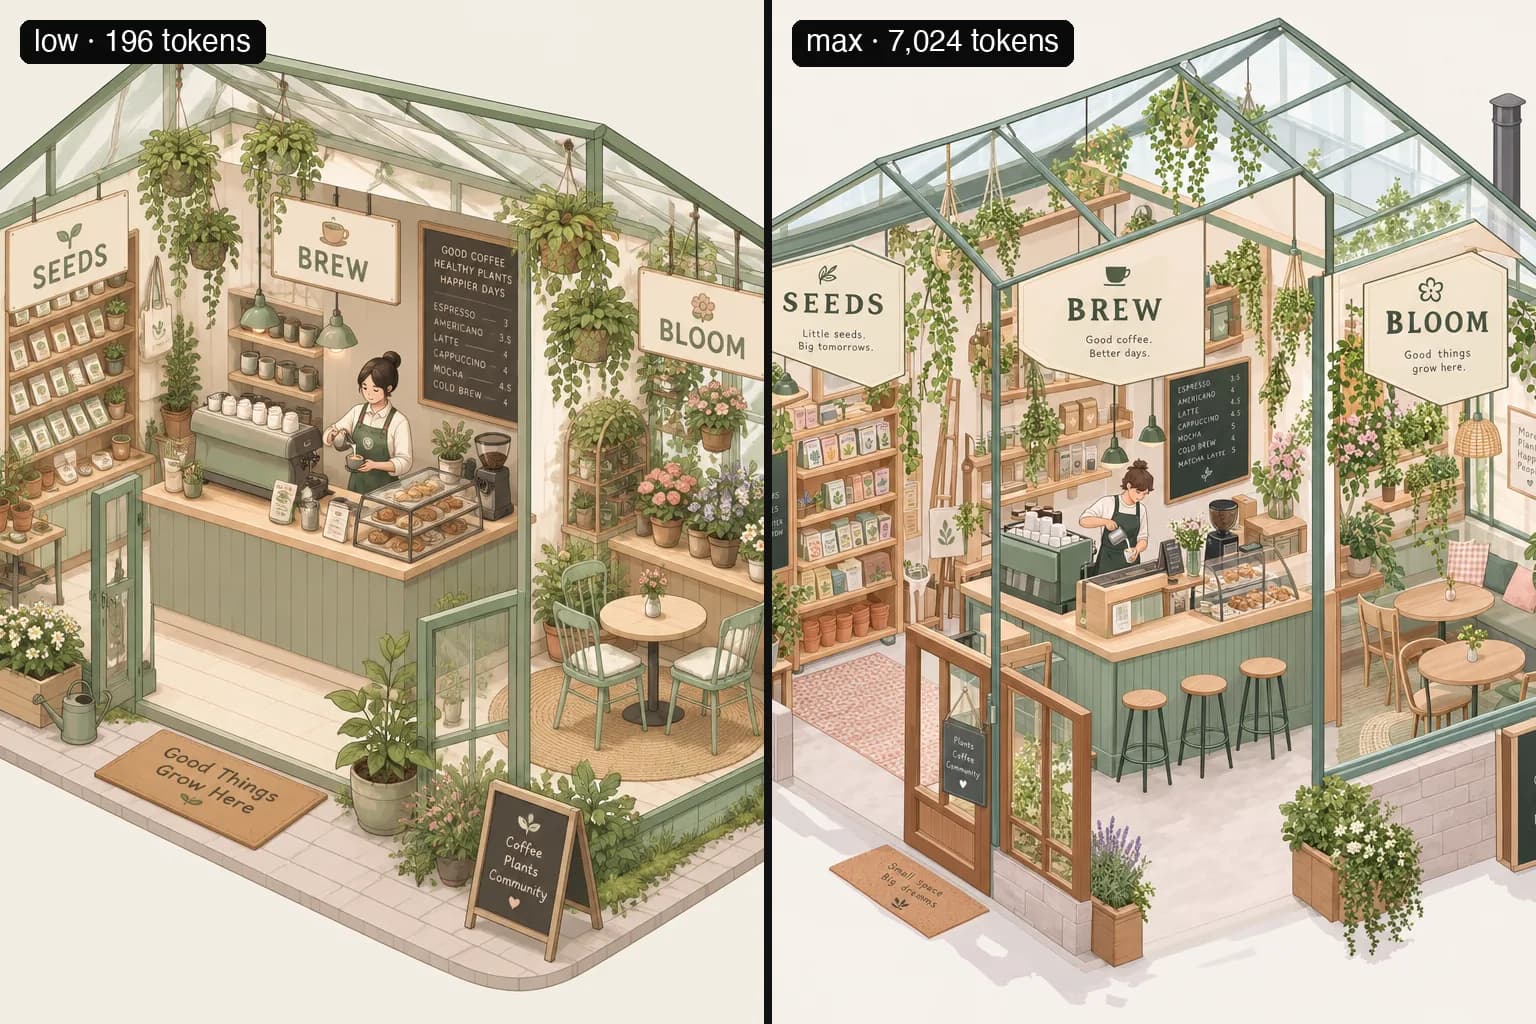
Nous avons envoyé le même prompt aux deux modèles, à chaque niveau de qualité, en 1024×1024 : un café-serre isométrique comprenant trois zones avec des inscriptions.
| Qualité | Tokens de sortie Flare | Tokens de sortie Sunburst |
|---|---|---|
| low | 196 | 196 |
| medium | 439 | 439 |
| high | 1 756 | 1 756 |
| xhigh | 3 122 | 3 122 |
| max | 7 024 | aucun décompte (rendu en échec) |
De low à xhigh, les décomptes sont identiques. Le rendu Sunburst en max a échoué : nous n’avons donc pas de comparaison pour cette ligne. Les deux modèles ont indiqué 50 tokens d’entrée texte pour le prompt. Un nombre de tokens identique au même tarif donne un coût identique : le prix ne devrait donc pas peser dans votre choix. Le détail des tarifs API de GPT Image 2.5 présente le coût par niveau de qualité.
Dans quels cas Sunburst est-il plus lent ?
Les durées sont exprimées en secondes, de la création de la tâche à sa fin, telles qu’indiquées dans la tâche. Elles incluent l’attente dans notre chaîne de traitement : comparez les écarts plutôt que les valeurs absolues.
Avec les ID -official, pour le même prompt de café en 1024×1024 :
| Qualité | Flare | Sunburst |
|---|---|---|
| low | 43 | 47 |
| medium | 42 | 63 |
| high | 47 | 63 |
| xhigh | 59 | 81 |
| max | 83 | échec après 424 s |
Sunburst était plus lent à tous les niveaux, avec 16 à 22 secondes de retard à partir de medium. Le rendu en max qui a échoué n’a renvoyé aucune image et le registre de facturation n’indique aucun débit, conformément au fonctionnement des tâches en échec sur TokLab.
Avec les ID Standard facturés à l’image, le constat est différent. Sur sept paires Flare/Sunburst en high et max, Flare a terminé en premier trois fois, Sunburst quatre fois. Les écarts les plus importants allaient dans les deux sens (café en high : 42 s contre 59 s ; affiche en max : 64 s contre 39 s). Si Flare est plus rapide sur ce canal, un seul essai par configuration n’a pas suffi à le montrer.
Quatre prompts, les images côte à côte
Tous ces résultats sont présentés sans retouche. Les légendes indiquent le modèle et la qualité.
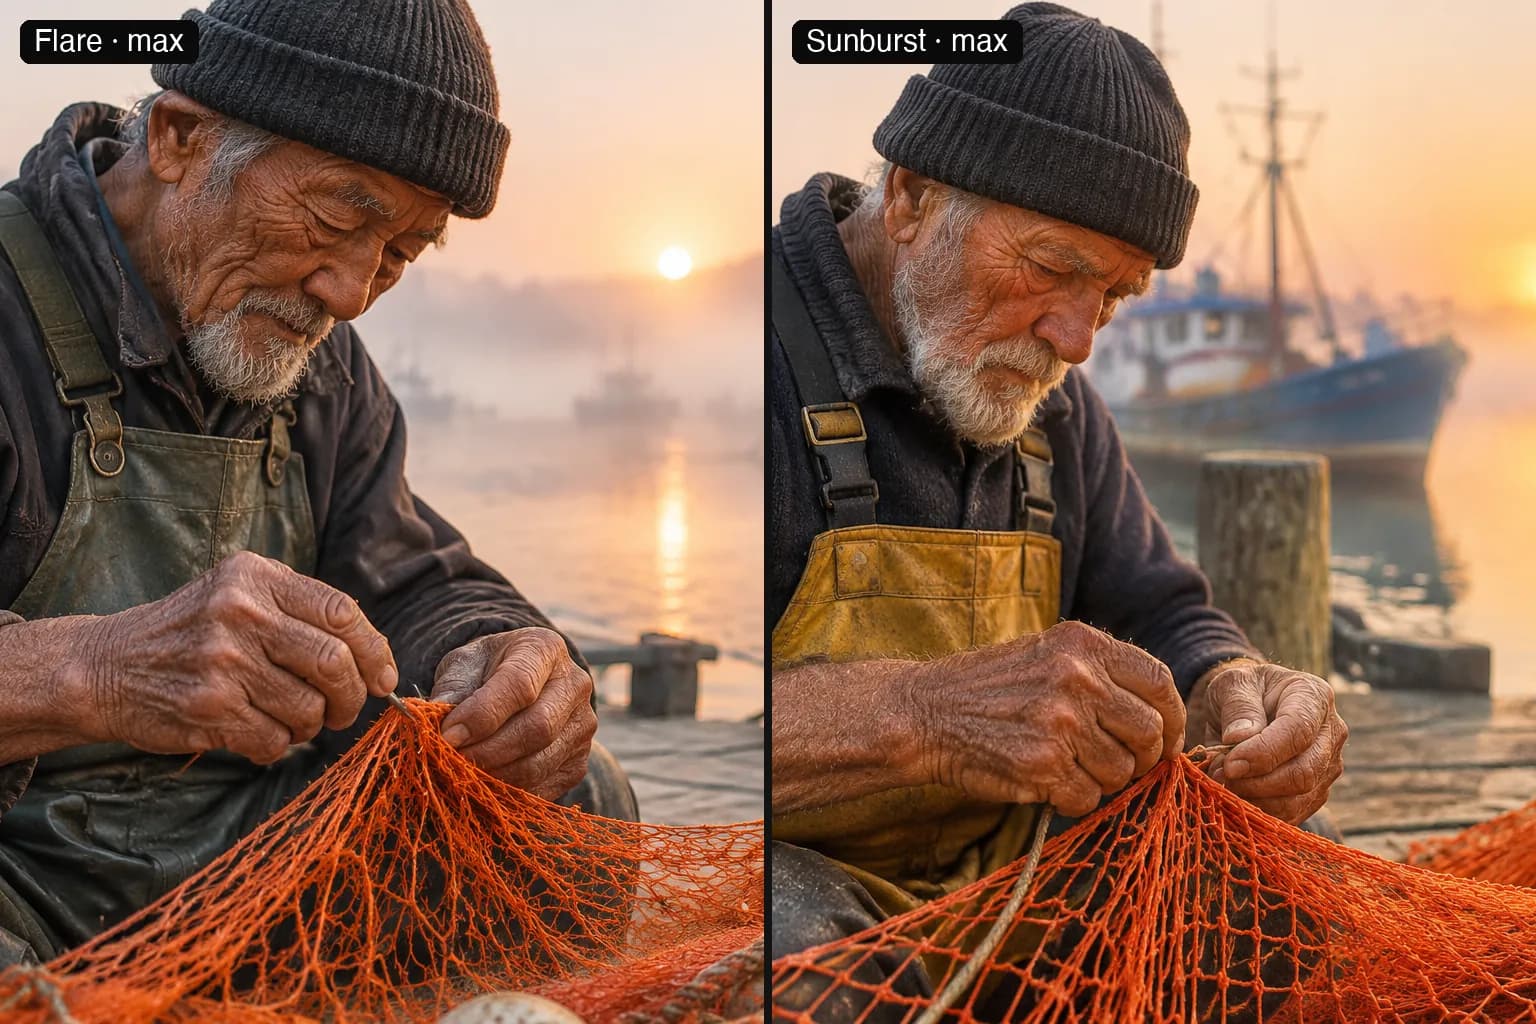
Le prompt du pêcheur demandait de la brume à l’aube, un filet orange et des mains bien nettes. Les deux modèles ont respecté ces trois points. Ils ont choisi des hommes, des bateaux et des éclairages différents : la brume de Flare est plus épaisse ; Sunburst a ajouté un phare et un soleil plus marqué. Aucun des deux ne présente les doigts déformés qui trahissaient autrefois ces images.
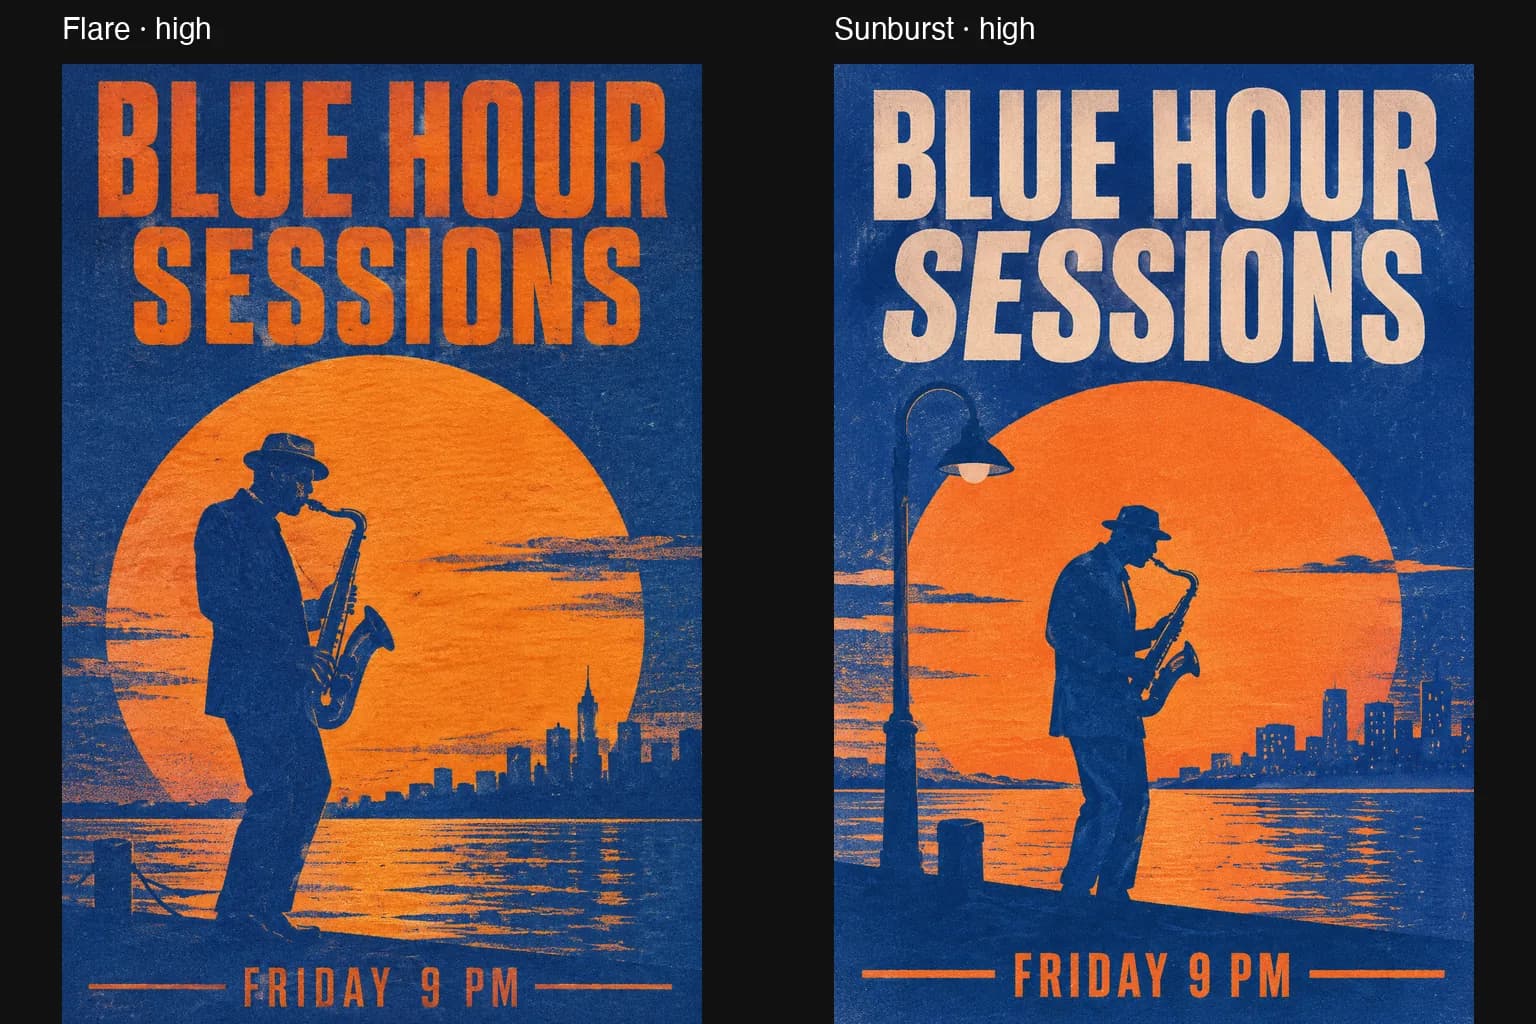
L’affiche sert à tester le texte. Les deux modèles ont écrit BLUE HOUR SESSIONS et FRIDAY 9 PM sans faute, respecté les deux encres et placé FRIDAY 9 PM en caractères condensés en bas, comme demandé. Sunburst a ajouté un réverbère qui ne figurait pas dans le prompt. C’est une question de goût, pas une erreur.
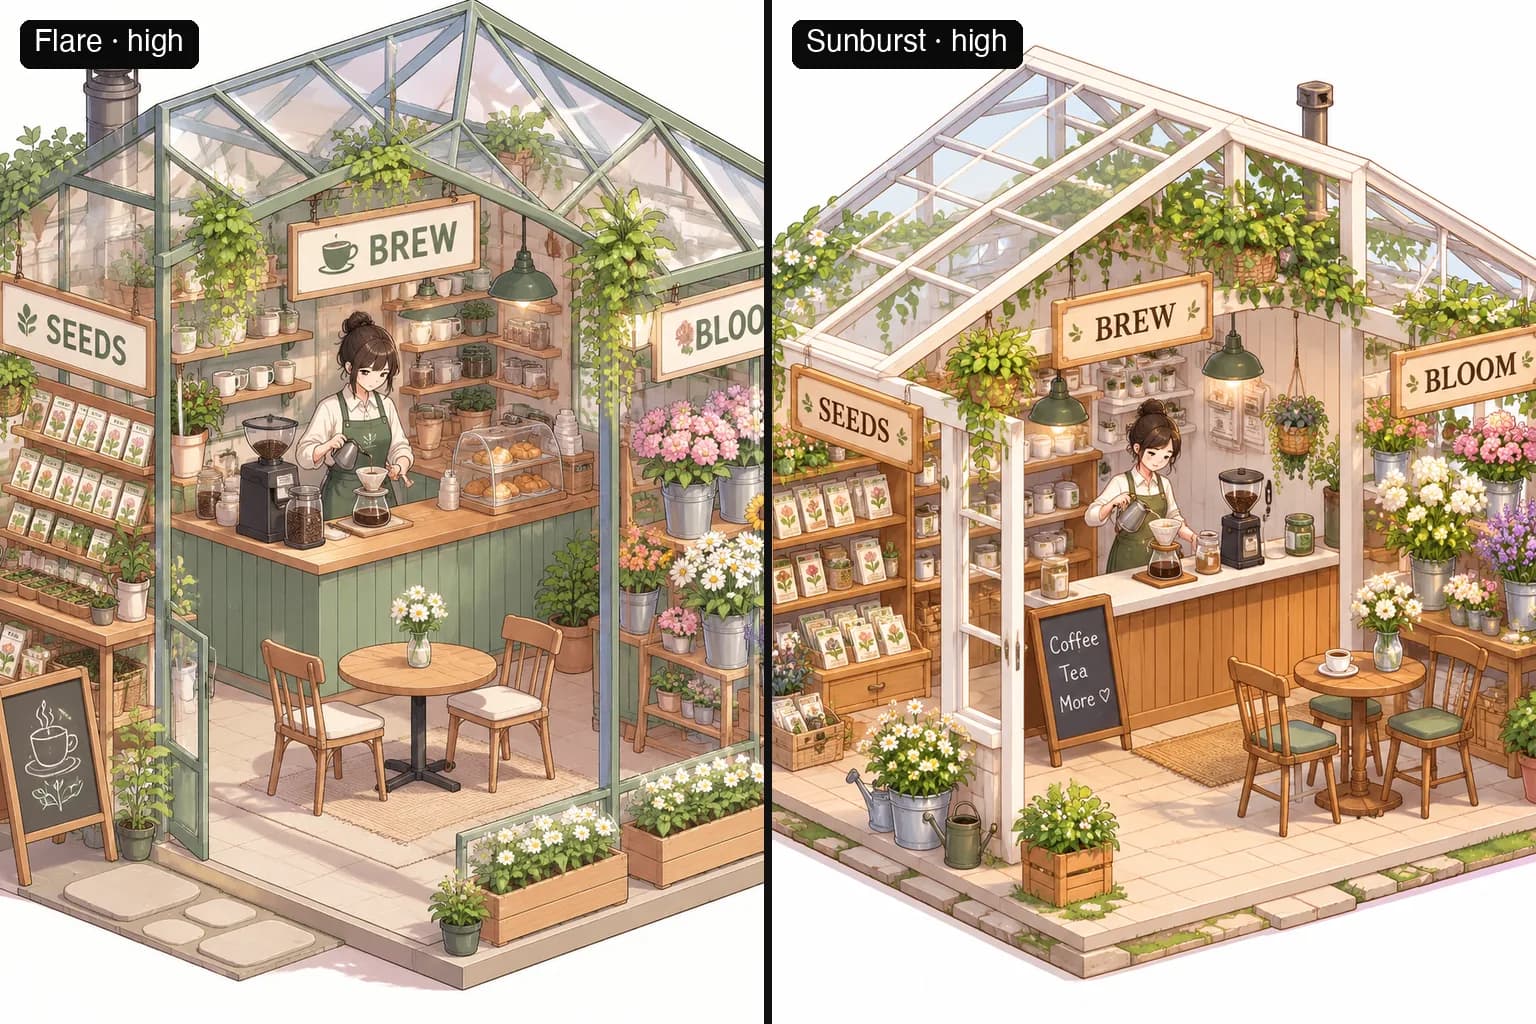
Les trois inscriptions demandées sont correctes sur les deux images. Les deux modèles ont aussi inventé d’autres panneaux et une carte des boissons lisible. Le bâtiment de Sunburst est plus rigide, plus architectural ; celui de Flare a des formes plus souples. Dans les deux cas, relisez les petits textes inventés avant toute publication.
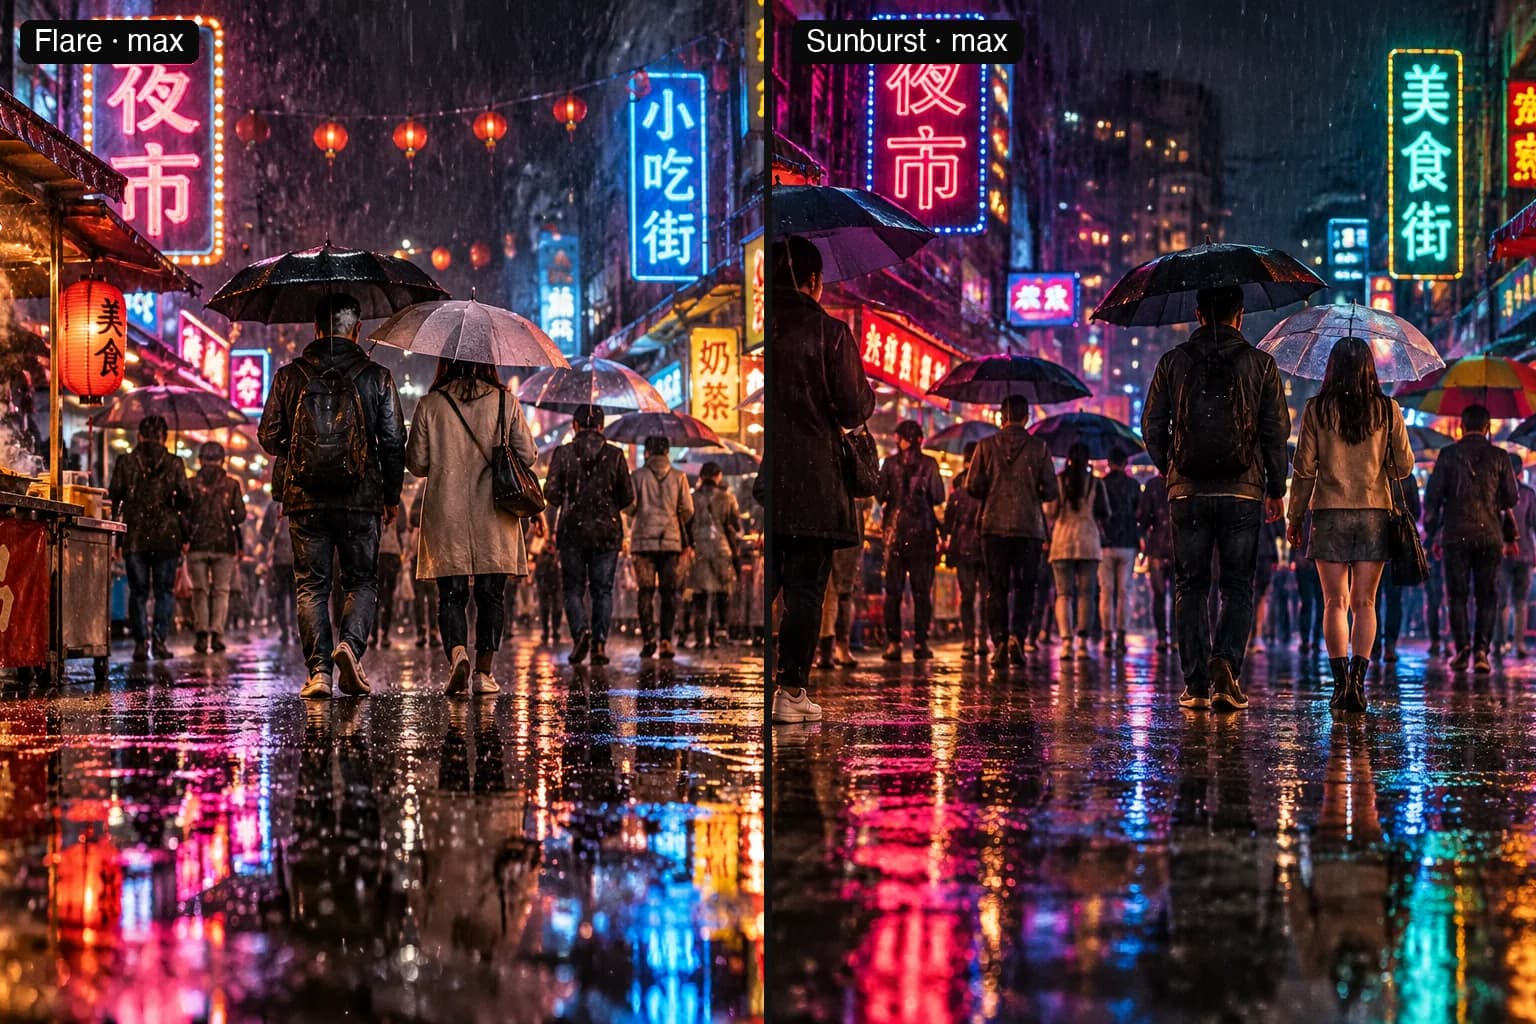
Le prompt du marché nocturne ne précisait ni langue ni ville. Les deux modèles ont spontanément choisi des enseignes en chinois. Les caractères que nous avons vérifiés (夜市, 烤串, 臭豆腐 et les autres) forment de vrais mots, employés correctement. Les reflets de Flare sont plus chargés ; la rue de Sunburst est plus épurée, son éclairage plus uniforme.
La différence tient au style, pas à la justesse. Si un rendu convient mieux à votre produit, c’est une bonne raison de choisir le modèle correspondant : cela ne coûte pas plus cher.
Ce que nous n’avons pas testé
Le principal manque concerne la retouche. OpenAI présente Sunburst comme le modèle « pour les processus où la précision des retouches compte le plus », et Flare comme son « modèle le plus rapide pour la génération quotidienne d’images de haute qualité » (pages des modèles). Nous avions prévu un test de retouche en trois passes, puis l’avons retiré de cette série. Nous n’avons donc aucune observation personnelle pour confirmer ou infirmer ces affirmations. Si votre produit repose surtout sur la retouche, testez vos propres références avec les deux modèles avant de choisir.
Deux autres limites : tous les décomptes de tokens portent sur du 1024×1024, alors que les formats plus grands en consomment davantage ; chaque durée provient d’un seul essai.
Comment savoir si vous avez utilisé Flare ou Sunburst ?
Dans les commentaires d’une vidéo YouTube, quelqu’un demandait : « Comment on va savoir si on utilise Sunburst ou Flare ? » Avec l’API, rien à deviner. Vous choisissez le modèle par son ID, aucun mécanisme ne le remplace, et la tâche terminée indique celui qui a été utilisé :
{ "id": "task_...", "model": "gpt-image-2.5-sunburst", "status": "completed" }Votre historique d’utilisation indique aussi le modèle et le montant facturé pour chaque tâche.
Quel ID utiliser dans votre code ?
Sur TokLab, chaque modèle dispose d’un ID Standard à prix fixe par image et d’un ID -official facturé au token :
gpt-image-2.5-flareetgpt-image-2.5-sunburstgpt-image-2.5-flare-officialetgpt-image-2.5-sunburst-official
Le corps de la requête est identique pour les quatre ID : un seul mot à changer pour passer de l’un à l’autre. Notre choix : commencez avec gpt-image-2.5-flare, affinez le prompt en qualité low, puis passez une tâche sur Sunburst pour une retouche si vos propres essais montrent qu’il préserve mieux l’original. Le Playground GPT Image 2.5 vous permet d’utiliser les deux modèles sur votre solde avec les mêmes champs que l’API. La référence API donne la liste complète des paramètres.