fal.ai-Alternativen: dieselben Modelle im Preisvergleich
Sechs fal.ai-Alternativen im Preisvergleich: veröffentlichte Tarife vom 4. November 2026 für dieselben Modelle und vier echte Seedance-Abrechnungen.
Als Markdown lesenfal.ai bietet eine gehostete API für Bild-, Video- und Audiomodelle. Auf der Startseite stehen über 1.500 generative Medienmodelle. Abgerechnet wird nach Ergebnis: pro Bild, pro Megapixel oder pro Videosekunde. Welche fal.ai-Alternative sich lohnt, hängt davon ab, welches Modell du bereits nutzt, was es anderswo kostet und worauf du beim Wechsel verzichten müsstest.
Dieser Vergleich setzt deshalb bei den Preisen an. Alle folgenden Zahlen stammen von der Preis- oder Modellseite der jeweiligen Plattform, wurden am 4. November 2026 geprüft und sind mit einem Link zur Quelle versehen. TokLab ist unser Produkt und gehört zur Auswahl. Wo fal günstiger ist, zeigen die Tabellen das auch.
Welche Alternative passt zu deinem Einsatz?
- Dieselben Modelle, niedrigerer Preis pro Einheit: TokLab und Runware. Für die Seedance-Familie liegen die veröffentlichten Token-Tarife von TokLab ungefähr bei der Hälfte der Tarife von fal.
- Der größte Katalog oder eigene Modelle: Replicate. Cloudflare nennt in der Übernahmeankündigung über 50.000 Modelle.
- Vor allem LLMs, dazu einige Medienmodelle: OpenRouter für den Zugriff auf Textmodelle verschiedener Anbieter, Together AI für offene Modelle und gemietete GPUs.
- LoRA-Training, private Deployments, reine GPU-Rechenzeit: Bleib bei fal oder miete selbst GPUs.
fal.ai: Funktionen, Preise und Abrechnung
Das sind die Konditionen von fal laut eigener Dokumentation.
- Abrechnung. Die Modell-APIs rechnen nach Ergebnis ab. In der Preisdokumentation von fal steht: „Berechnet werden erfolgreich generierte Ergebnisse.“ Serverfehler werden nie berechnet, und die Wartezeit in der Warteschlange ist kostenlos. Eine fehlgeschlagene Anfrage kostet bei fal also bereits nichts. Das ist kein Grund für einen Wechsel.
- Guthabenverfall. fal arbeitet mit Vorauszahlung. Laut den Nutzungsbedingungen wird gekauftes Guthaben „365 Tage nach dem Kaufdatum verfallen“. Kostenloses Guthaben und Aktionsguthaben verfallen nach 90 Tagen.
- Parallele Anfragen. Ein neues Konto kann 2 Anfragen gleichzeitig ausführen. Das Limit steigt mit dem „Gesamtbetrag der bezahlten Rechnungen aus den letzten vier Wochen“ auf bis zu 40, ohne dass du den Vertrieb kontaktieren musst. Darüber hinaus ist eine Absprache mit dem Vertrieb nötig (Dokumentation zu Parallelitätslimits). Anfragen über dem Limit landen in der Warteschlange, statt fehlzuschlagen.
- LLMs. Die Text-Endpunkte von fal liegen unter
openrouter/router. Hinter den Chatmodellen von fal steckt also OpenRouter, erreichbar über die API von fal. - GPUs. fal vermietet auch Rechenleistung: Auf der Preisseite steht eine H100 mit einem Listenpreis von $4.50 pro Stunde, „schon ab $2.49,“ wie dort angegeben.
Damit bleiben drei konkrete Gründe, sich umzusehen: die Preise der tatsächlich genutzten Modelle, die anfangs begrenzte Zahl paralleler Anfragen und verfallendes Guthaben.
Seedance 2.0 Fast bei 720p: ein Modell, fünf Preise
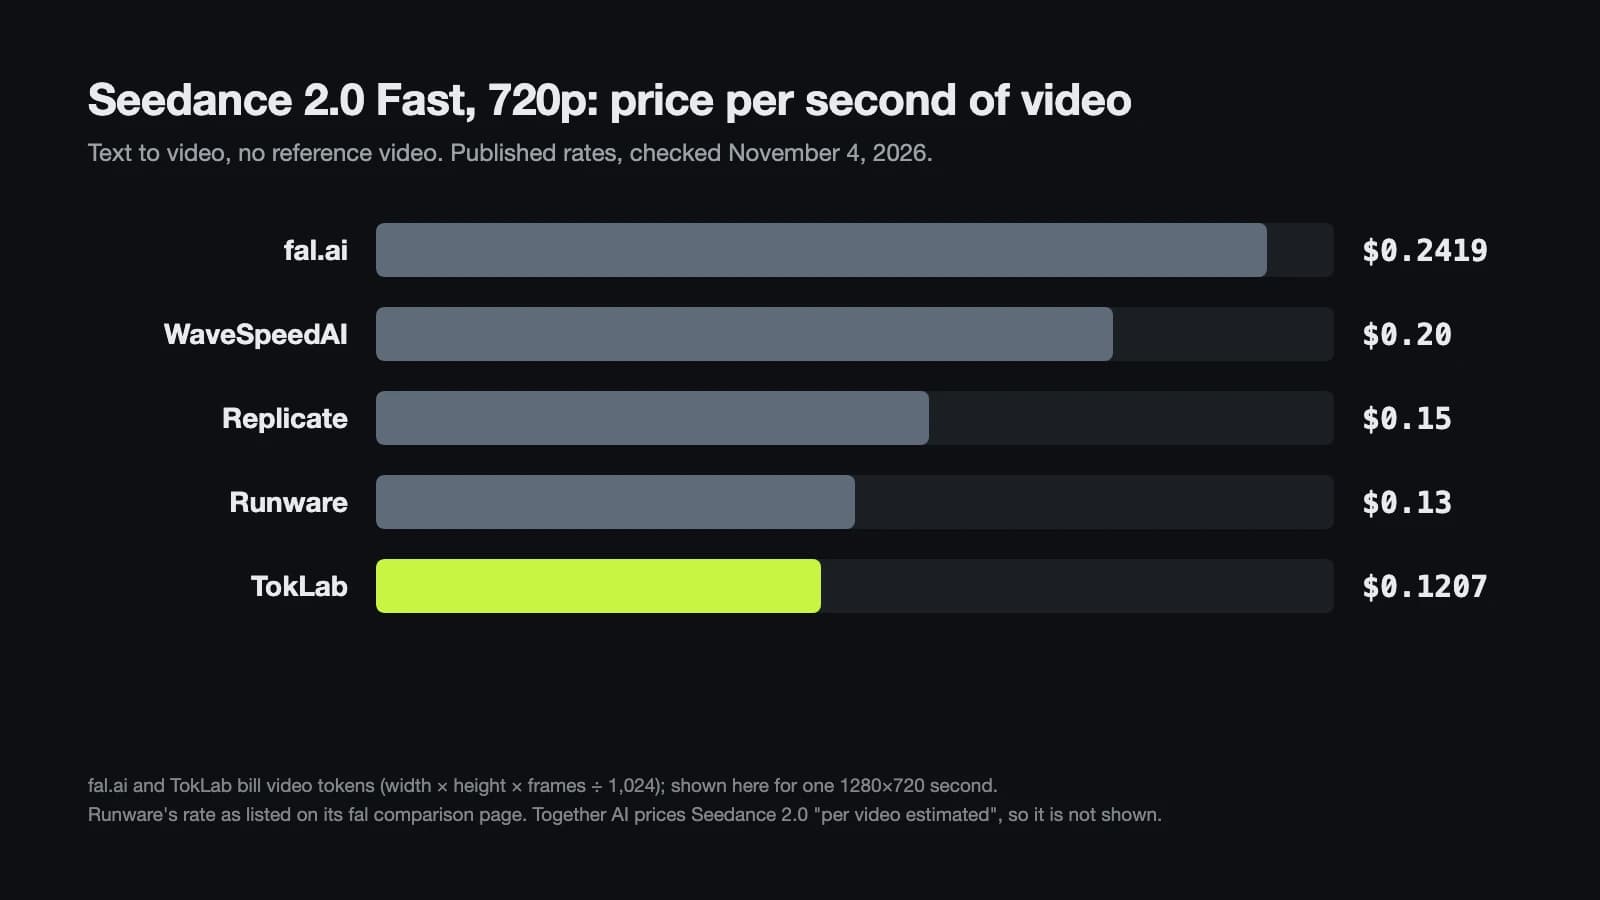
Seedance 2.0 Fast gibt es auf den meisten dieser Plattformen und eignet sich deshalb für einen direkten Vergleich. Die Zahl gibt jeweils den Preis für eine Sekunde 720p-Video aus einem Text-Prompt ohne Referenzvideo an.
| Plattform | 720p, pro Sekunde | Abrechnung nach |
|---|---|---|
| fal.ai | $0.2419 | Video-Token, $0.0112 pro 1.000 |
| WaveSpeedAI | $0.20 | generierter Videosekunde |
| Replicate | $0.15 | generierter Videosekunde |
| Runware | $0.13 | generierter Videosekunde |
| TokLab | $0.1207 | Video-Token, $5.588 pro Million |
Die Zahl für Runware ist der Preis, den Runware auf seiner fal-Vergleichsseite neben den $0.2419 von fal nennt.
fal und TokLab rechnen Seedance beide nach Video-Token ab. Die Formel lautet: Token = Breite × Höhe × Frames ÷ 1.024. Eine Sekunde mit 1280×720 und 24 Frames ergibt 21.600 Token. So werden aus $0.0112 pro tausend die von fal selbst veröffentlichten $0.2419. Der TokLab-Wert ergibt sich aus derselben Rechnung mit dem dortigen Tarif.
Together AI bietet ebenfalls Seedance 2.0 an. Auf der Preisseite steht allerdings „geschätzt $0.16 pro Video“, ohne Auflösung oder Länge. Damit lässt sich der Preis nicht in eine Tabelle mit Sekundenpreisen einordnen.
Bei 480p bleibt die Reihenfolge gleich. Der Token-Tarif von fal ergibt für einen Clip in 16:9 einen Preis von $0.1125 pro Sekunde. WaveSpeedAI nennt $0.10, Replicate $0.07 und TokLab $0.0561.
fal.ai und TokLab: dieselben Modelle im Preisvergleich
Hier stehen die Modelle, die beide anbieten, zum Listenpreis von fal: Text oder Bild zu Video, ohne Referenzvideo. Die TokLab-Werte stammen aus den aktuellen Preistabellen auf toklab.ai/pricing und den Dokumentationsseiten der einzelnen Modelle.
Seedance, pro 1.000 Video-Token
| Modell | fal.ai | TokLab | TokLab gegenüber fal |
|---|---|---|---|
| Seedance 2.5, 480p–720p | $0.0214 | $0.010681 | −50% |
| Seedance 2.5, 1080p | $0.0234 | $0.011671 | −50% |
| Seedance 2.0, 480p–720p | $0.014 | $0.006996 | −50% |
| Seedance 2.0, 1080p | $0.014 | $0.007678 | −45% |
| Seedance 2.0 Fast | $0.0112 | $0.005588 | −50% |
| Seedance 2.0 Mini | $0.007 | $0.003729 | −47% |
Video mit Abrechnung pro Sekunde
| Modell | fal.ai | TokLab | TokLab gegenüber fal |
|---|---|---|---|
| Grok Imagine Video 1.5, 480p | $0.08 | $0.04 | −50% |
| Grok Imagine Video 1.5, 720p | $0.14 | $0.08 | −43% |
| Veo 3.1 Fast, 1080p, mit Audio | $0.15 | $0.1104 | −26% |
| Kling 4.0, 720p | $0.157 | $0.1425 | −9% |
| MiniMax H3 Max, 768p | $0.08 | $0.07313 | −9% |
| Veo 3.1, 1080p, mit Audio | $0.40 | $0.368 | −8% |
Die beiden Veo-Zeilen entsprechen auf TokLab veo-3.1-fast-official und veo-3.1-quality-official.
Bilder
| Modell | fal.ai | TokLab | TokLab gegenüber fal |
|---|---|---|---|
| Nano Banana 2.1, pro 1 Mio. Bild-Ausgabe-Token | $35.294 | $19.50 | −45% |
| GPT Image 2.5, pro 1 Mio. Bild-Ausgabe-Token | $30.00 | $22.50 | −25% |
| FLUX 3 Image Klein, 1K, pro Bild | $0.009 | $0.00847 | −6% |
Bei Seedance, Grok Imagine und Nano Banana ist der Abstand groß, bei Kling, Veo 3.1 Quality und FLUX klein. Eine Plattform kann bei einem Modell halb so viel kosten und beim nächsten nur wenige Prozent günstiger sein. Rechne deshalb die Preise für die zwei oder drei Modelle durch, die du tatsächlich aufrufst.
Für zwei Zeilen bietet TokLab eine günstigere Route als die in der Tabelle. veo-3.1-fast berechnet pauschal $0.168 pro 8-Sekunden-Clip unterhalb von 4K. Diese Route hat weniger Optionen als die pro Sekunde abgerechnete ID; es gibt keinen Schalter für Audio. Die Festpreis-IDs von GPT Image 2.5 kosten von niedriger bis hoher Qualität $0.021 pro Bild. Das ist weniger als die Hälfte des fal-Preises von $0.0528 für ein 1024×1024-Bild mit hoher Qualität.
Bei welchen Modellen ist fal aktuell günstiger?
fal hat Rabattaktionen für MiniMax H3. Vom 1. bis 15. November 2026 gibt es laut der H3 Max-Seite 30% Rabatt: $0.035 pro Sekunde bei 480p und $0.056 bei 768p. TokLab berechnet $0.0457 und $0.07313, womit fal bis zum Ende der Aktion 23% günstiger ist. Ab dem 16. November gelten bei fal wieder die Listenpreise von $0.05 und $0.08, womit TokLab wieder 9% darunter liegt. Bei H3 Max Turbo sieht es genauso aus: $0.0175 und $0.028 bei fal gegenüber $0.02285 und $0.03656 bei TokLab.
Ein weiterer Fall ist GPT Image 2.5 mit niedriger Qualität. Der Festpreis von $0.021 gilt auch dafür, während fal ein 1024×1024-Bild mit niedriger Qualität nach Token abrechnet: $0.0060. Wenn du viele kleine Entwürfe mit niedriger Qualität generierst, ist die Token-Abrechnung von fal günstiger als der Festpreis. Das gilt auch für die Token-Route von TokLab mit -official für $22.50 pro Million Ausgabe-Token.
Vier echte Seedance-Anfragen: Was wurde berechnet?
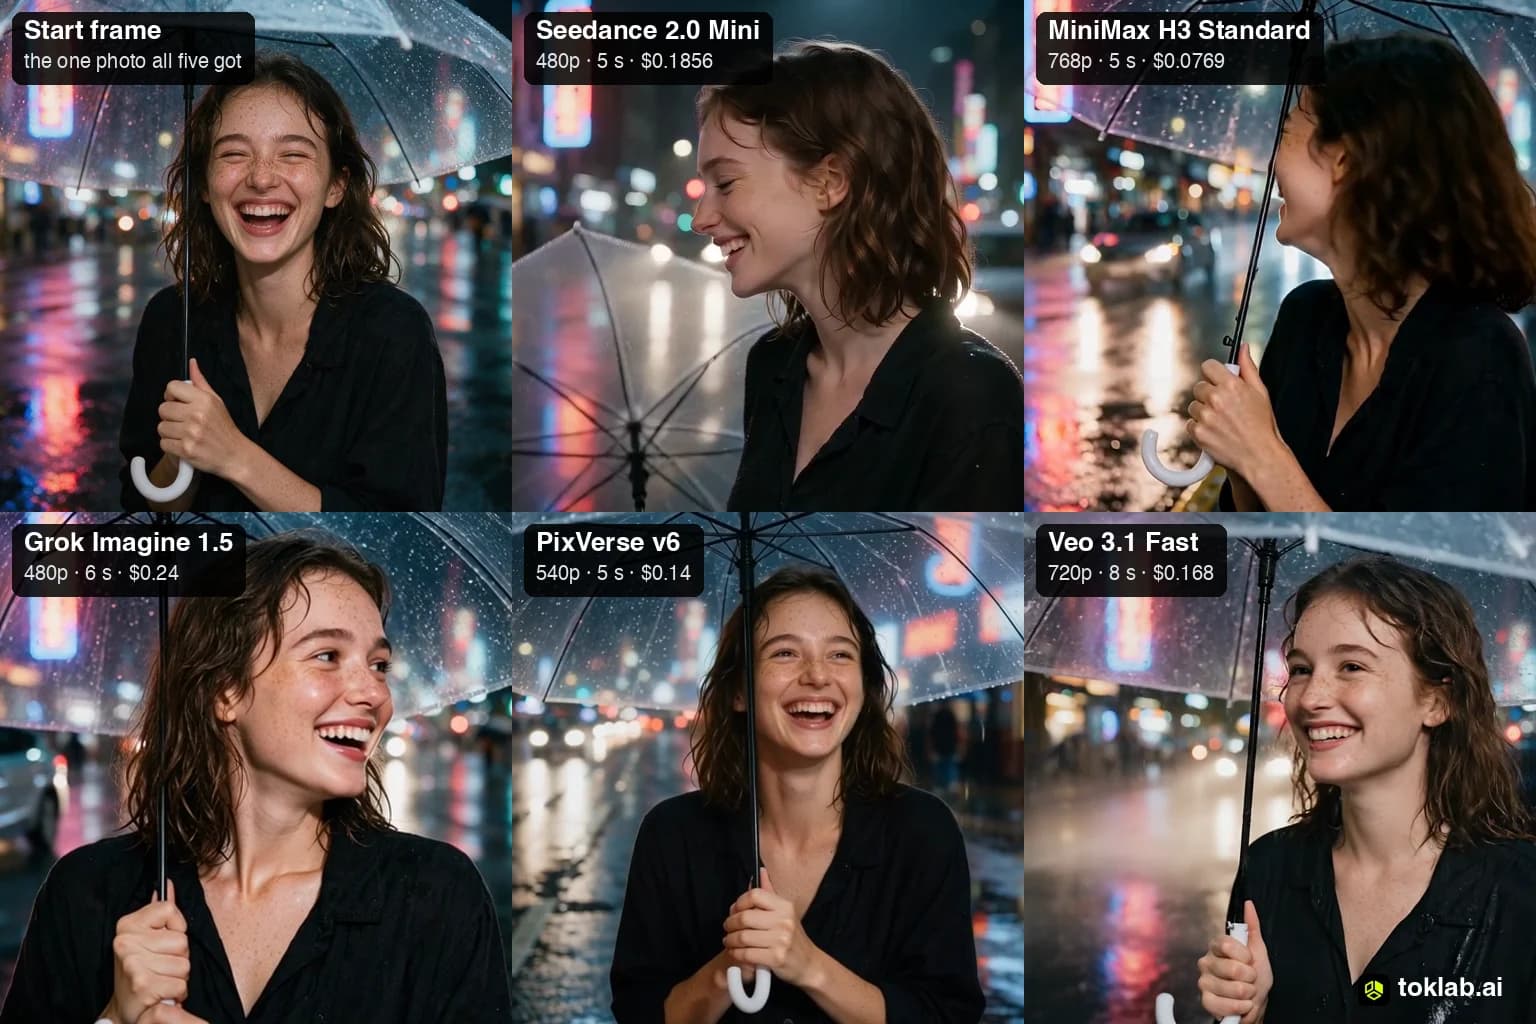
Am 3. November 2026 haben wir auf TokLab an jedes Seedance-Modell eine Text-zu-Video-Anfrage gesendet: 480p, 4:3, 4 Sekunden. Daraus entstehen Videos mit 752×560. Das Gateway hat jeweils 39.891 Token abgerechnet, weil es für 4 Sekunden 97 Frames zählt, einen mehr als 4 × 24.
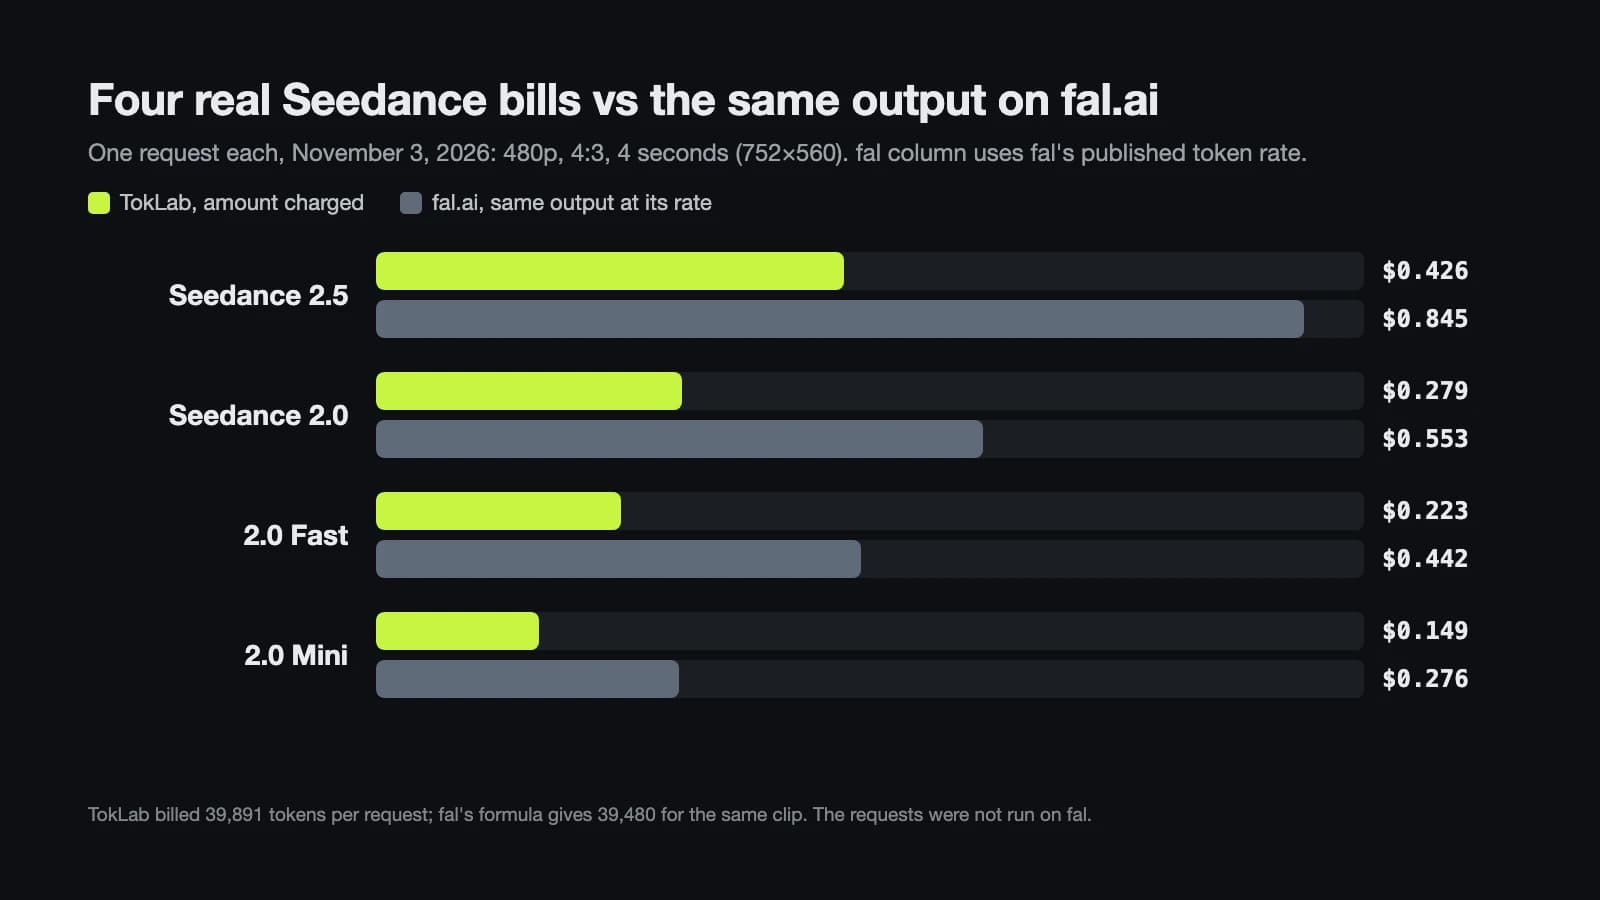
| Modell | Von TokLab berechnet | Dasselbe Ergebnis zum Tarif von fal | Differenz |
|---|---|---|---|
| Seedance 2.5 | $0.426076 | $0.8449 | −50% |
| Seedance 2.0 | $0.279078 | $0.5527 | −50% |
| Seedance 2.0 Fast | $0.222910 | $0.4422 | −50% |
| Seedance 2.0 Mini | $0.148754 | $0.2764 | −46% |
Die fal-Spalte verwendet für denselben Clip die Token-Formel von fal, die 39.480 Token ergibt, und den veröffentlichten Tarif des jeweiligen Modells. Wir haben diese Anfragen nicht auf fal ausgeführt. Jeder auf TokLab berechnete Betrag ergab sich aus Token × Tarif, gerundet auf das nächste Vielfache von $0.000002, den kleinsten Betrag, der abgerechnet wird. Für einen 5-Sekunden-Clip mit Mini und denselben Einstellungen wurden 49.761 Token berechnet, insgesamt $0.185558.
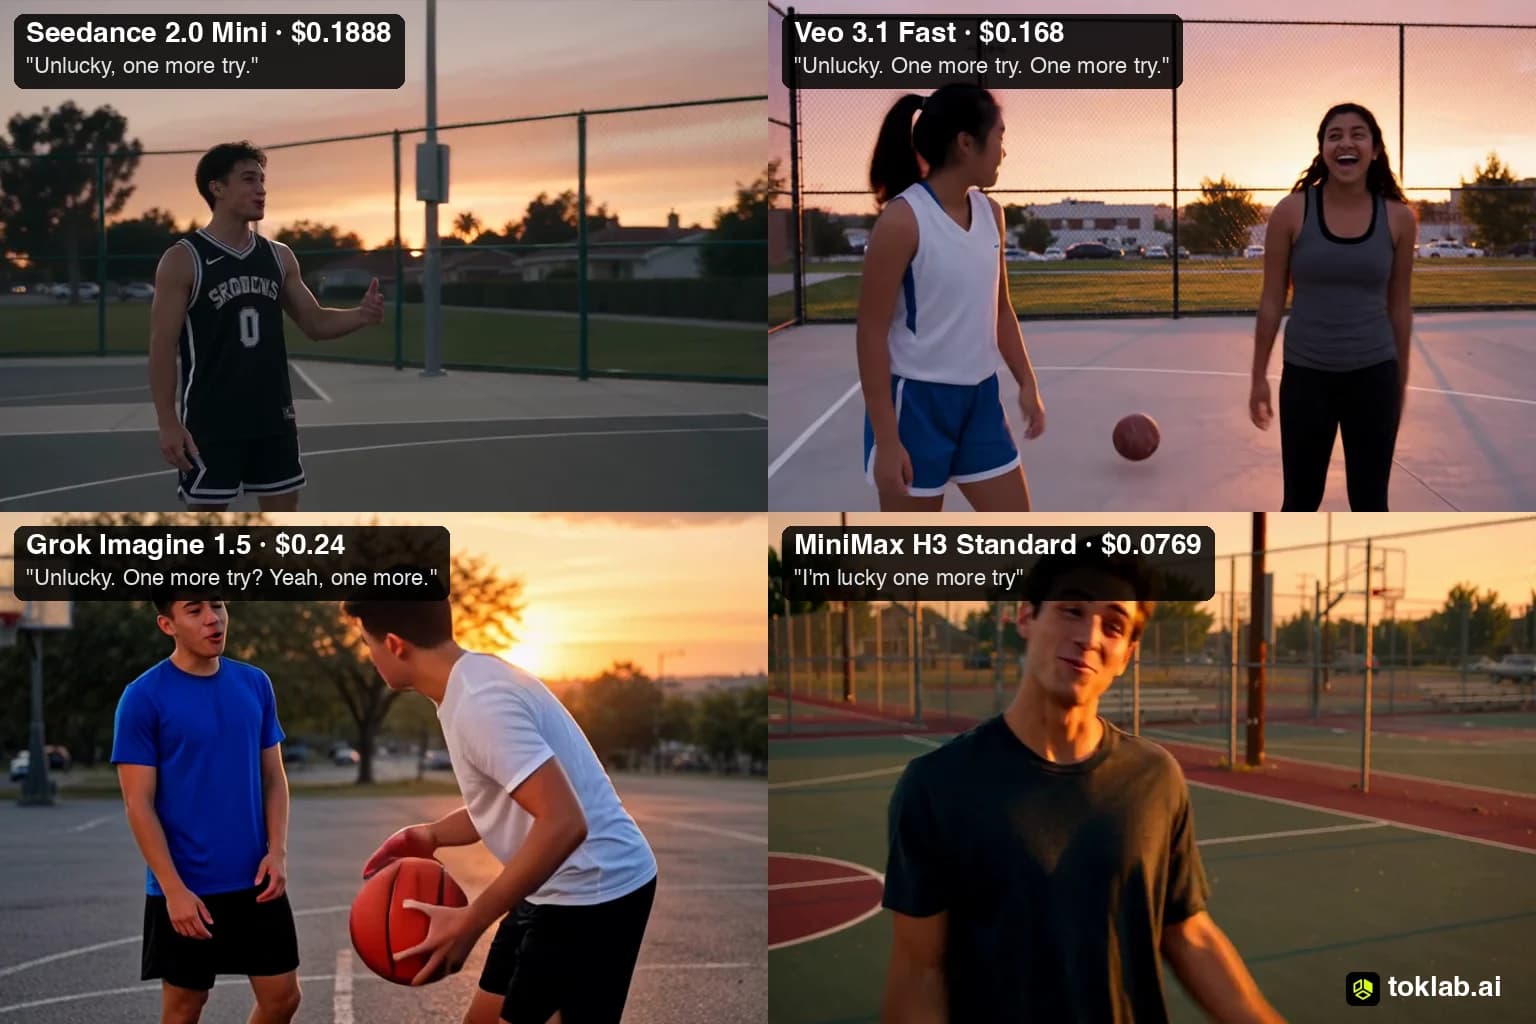
Am 4. November haben wir die vier Anfragen mit einem anderen Prompt wiederholt; die Clips siehst du im Bild oben. Jede Anfrage ergab erneut 39.891 Token und kostete genauso viel wie am Vortag. Die Abrechnung hängt von Auflösung, Seitenverhältnis und Länge ab, nicht vom Bildinhalt.
Die fal.ai-Alternativen im Einzelnen
TokLab
TokLab bietet eine einzige API für Bild-, Video-, Audio- und Textmodelle, mit einem Guthaben und einem API-Schlüssel. Video- und Bildaufträge gehen an /v1/videos/generations und /v1/images/generations; die Ergebnisse werden über /v1/tasks/{id} abgerufen. Textmodelle nutzen die OpenAI-kompatiblen Endpunkte /v1/chat/completions und /v1/responses. Auf der Modellseite stehen 44 Modelle, darunter Seedance 2.5 und 2.0, Kling, Veo 3.1, GPT Image 2.5, Nano Banana, Claude und GPT-6. Viele gibt es über zwei Routen: eine zum Festpreis pro Ergebnis und eine mit -official, die nach Token abgerechnet wird.
Guthaben verfällt nicht, fehlgeschlagene Aufgaben werden nicht berechnet, und der Mindestbetrag zum Aufladen liegt bei $20.
Ebenso wichtig ist, was fehlt: LoRA-Training, das Bereitstellen eigener Modelle und GPU-Miete gibt es nicht. Aufgabenergebnisse werden per Polling abgefragt. Laut der Webhook-Seite stellen die Aufgaben-APIs „keinen öffentlichen Webhook für den Abschluss einer Aufgabe bereit“. Und 44 Modelle sind nur ein kleiner Teil der über 1.500 Modelle von fal.
Am besten geeignet für: Teams, die einige wenige verbreitete Video- und Bildmodelle in großem Umfang nutzen, dafür niedrigere Preise pro Einheit suchen und LLMs mit demselben API-Schlüssel aufrufen möchten.
Replicate
Replicate hat den größten Katalog in dieser Auswahl. Cloudflare hat am 17. November 2025 angekündigt, eine Vereinbarung zur Übernahme von Replicate getroffen zu haben, und dabei über 50.000 produktionsreife Modelle genannt. Offizielle Modelle wie Seedance 2.0 Fast werden pro generierter Videosekunde abgerechnet: $0.07 bei 480p und $0.15 bei 720p. Bei Community-Modellen und eigenen Deployments zählt stattdessen die Hardwarelaufzeit. Eine H100 kostet laut Preisseite $0.001525 pro Sekunde oder $5.49 pro Stunde.
Replicate ist die Anlaufstelle für spezielle Fine-Tunes oder Forschungsmodelle, die in keinem kuratierten Katalog stehen. Der Nachteil: Bei sekundengenauer Hardwareabrechnung hängen die Kosten eines Community-Modells von seiner Laufzeit ab.
Am besten geeignet für: Projekte, die ein bestimmtes offenes Modell brauchen oder ein eigenes veröffentlichen möchten.
Runware
Runware betreibt Modelle auf einem eigenen Inferenz-Stack und tritt direkt gegen fal an. Die Vergleichsseite mit fal stellt 63 Modelle gegenüber und nennt eine durchschnittliche Ersparnis von 43% pro Modell. Die größte einzelne Ersparnis beträgt laut Runware 92%: bei FLUX.1 [dev] SRPO mit $0.0019 gegenüber $0.025 pro Bild. Das sind Runwares eigene Angaben. Auf der Seite kannst du vor der Anmeldung die Preise für dein Modell prüfen.
Am besten geeignet für: Bildlastige Anwendungen mit offenen Modellen. Varianten von FLUX und Qwen-Image belegen die meisten vorderen Plätze in der Tabelle zur Preisersparnis.
WaveSpeedAI
WaveSpeedAI hostet viele derselben Videomodelle und berechnet Sekundenpreise je nach Auflösung. Auf der Modellseite kostet Seedance 2.0 Fast $0.10 pro Sekunde bei 480p und $0.20 bei 720p. Neben jedem Tarif stehen bereits die Gesamtpreise für 5, 10 und 15 Sekunden. Bei 720p liegt der Preis damit 17% unter fal. Der Abstand ist kleiner als bei Replicate, Runware oder TokLab.
Am besten geeignet für: Videoteams, die Sekundenpreise direkt aus einer Tabelle ablesen möchten.
Together AI
Together AI ist eine Inferenz-Cloud für offene Modelle. Die Preisseite beginnt mit serverlosen Textmodellen, danach folgen dedizierte Endpunkte und GPU-Miete: Eine HGX H100 kostet $1.99 pro GPU-Stunde mit möglicher Unterbrechung oder $3.99 bei On-Demand-Nutzung. Auch Medienmodelle sind aufgeführt, darunter Seedance 2.5 und 2.0. Deren Preise werden allerdings als „Schätzung pro Video“ angegeben, was die Planung eines Videobudgets erschwert.
Am besten geeignet für: Produkte, die vor allem LLMs und daneben einige Bild- oder Videofunktionen brauchen.
OpenRouter
OpenRouter ermöglicht mit einem API-Schlüssel den Zugriff auf Textmodelle vieler Anbieter und hat inzwischen auch eine asynchrone API zur Videogenerierung. Der Dienst übernimmt das Routing: Er hostet und trainiert keine Modelle und vermietet keine GPUs. Auch die Chat-Endpunkte von fal laufen darüber.
Am besten geeignet für: Textmodelle vieler Anbieter mit einem API-Schlüssel und einer Rechnung.
GPUs selbst mieten
Bei gleichmäßiger Auslastung kann eine stundenweise abgerechnete GPU günstiger sein als jeder Preis pro Ergebnis. Du bezahlst die Maschine, nicht das Ergebnis. Als Vergleichswerte dienen die H100 bei fal mit $2.49 bis $4.50 pro Stunde, bei Together mit $1.99 mit möglicher Unterbrechung oder $3.99 bei On-Demand-Nutzung und bei Replicate ($5.49). Dafür musst du alles selbst übernehmen, was dir eine gehostete API abnimmt: Modellgewichte laden, Kaltstarts bewältigen, skalieren und die Maschine auslasten.
Wann lohnt es sich, bei fal.ai zu bleiben?
fal ist die bessere Wahl, wenn du LoRAs trainierst, private oder feinabgestimmte Modelle bereitstellst, 3D- oder Text-zu-Sprache-Modelle brauchst – TokLab hat beides nicht – oder auf die Warteschlange und Webhooks von fal angewiesen bist. Wenn du oft Modelle wechselst, lässt sich der Katalog mit über 1.500 Modellen ebenfalls schwer ersetzen. Und bis einschließlich 15. November 2026 laufen MiniMax H3 Max und H3 Max Turbo dort günstiger.
Anbieter wechseln: Was solltest du vorher prüfen?
- Notiere die aufgerufenen Endpunkte und ihr monatliches Volumen. Berechne die Kosten bei jedem infrage kommenden Anbieter mit deiner tatsächlichen Auflösung und Länge. 50% Ersparnis bei einem selten genutzten Modell bringen weniger als 9% bei deinem Hauptmodell.
- Ordne Modell-IDs und Anfrage-Bodys zu. Das Modell
bytedance/seedance-2.0/fast/text-to-videobei fal heißt bei TokLabdreamina-seedance-2-0-fast. Auch das Anfrageformat ist anders: Seedance auf TokLab erwartet dascontent-Array von ByteDance. - Ersetze Webhooks, falls du sie nutzt. Auf TokLab fragst du
GET /v1/tasks/{id}per Polling ab, bis der Statuscompletedoderfailedlautet. - Prüfe die Zählweise der Frames. Bei Video mit Token-Abrechnung werden Frames gezählt. Je nach Anbieter kann die Zahl um einen Frame pro Clip abweichen. Bei einem 4-Sekunden-Clip macht das ungefähr 1% aus, fällt aber beim Abgleich der Abrechnung auf.
- Verbrauche zuerst dein Guthaben bei fal. Gekauftes Guthaben verfällt dort 365 Tage nach dem Kauf.
Häufige Fragen
Welche fal.ai-Alternative ist für Seedance günstiger?
TokLab ist günstiger. Die veröffentlichten Seedance-Token-Tarife liegen für 2.5, 2.0, Fast und Mini ungefähr bei der Hälfte der fal-Tarife. Unsere vier Testanfragen vom 3. November 2026 kosteten 46% bis 50% weniger als dieselben Ergebnisse zu den Tarifen von fal. Auch Replicate und Runware bieten Seedance 2.0 Fast bei 720p laut ihren Preislisten günstiger als fal an.
Berechnet fal.ai fehlgeschlagene Anfragen?
Nein. fal berechnet nur erfolgreich generierte Ergebnisse. Anfragen, die mit einem Serverfehler fehlschlagen, werden nicht berechnet. TokLab handhabt das genauso.
Verfällt mein Guthaben bei fal.ai?
Ja. Laut den Nutzungsbedingungen von fal verfällt gekauftes Guthaben 365 Tage nach dem Kauf, kostenloses Guthaben und Aktionsguthaben nach 90 Tagen. Guthaben bei TokLab verfällt nicht.
Ist Replicate günstiger als fal.ai?
Das hängt vom Modell ab. Seedance 2.0 Fast kostet bei Replicate $0.15 pro Sekunde bei 720p, bei fal $0.2419. Bei Community-Modellen mit Abrechnung nach GPU-Zeit hängen die Kosten von der Laufzeit ab. Teste sie deshalb mit deinen eigenen Eingaben.
Kann ich LLMs und Videomodelle mit einem API-Schlüssel nutzen?
Auf TokLab ja: Textmodelle nutzen die OpenAI-kompatiblen Endpunkte, Medienmodelle die Aufgaben-Endpunkte. Alles wird über ein Guthaben abgerechnet. Auch fal bietet Chatmodelle an, die über OpenRouter laufen.
Welche fal.ai-Alternative lohnt sich für dich?
Für die meisten Teams ist die passende fal.ai-Alternative diejenige, die bei ihren zwei oder drei meistgenutzten Modellen am günstigsten ist. Bei der Seedance-Familie und Grok Imagine Video liegen die Tarife von TokLab 43% bis 50% unter den fal-Tarifen. Bei Kling, Veo 3.1 Quality und FLUX beträgt der Abstand weniger als 10%, und bei MiniMax H3 Max ist fal bis zum 15. November günstiger. Berechne deine eigenen Kosten mit den Tabellen oben und prüfe die aktuellen Tarife, bevor du deine Anfragen umstellst.