Alternatives à fal.ai : les mêmes modèles, tarifs à l’appui
Comparez six alternatives à fal.ai sur les mêmes modèles : tarifs publiés vérifiés le 4 novembre 2026 et quatre factures Seedance réelles.
Lire en Markdownfal.ai est une API hébergée qui donne accès à des modèles de génération d’images, de vidéos et d’audio. Sa page d’accueil annonce plus de 1 500 modèles de génération de médias, avec une facturation au résultat : par image, par mégapixel ou par seconde de vidéo. Pour choisir une alternative à fal.ai, il faut partir du modèle que vous utilisez déjà, comparer son coût ailleurs et voir ce que vous perdriez en changeant de plateforme.
Ce comparatif part donc des prix. Tous les chiffres ci-dessous proviennent des pages de tarifs ou des fiches de modèles des plateformes, consultées le 4 novembre 2026, avec un lien vers chaque source. TokLab est notre produit et figure dans la liste. Quand fal est moins cher, les tableaux le montrent.
Quelle plateforme choisir ?
- Les mêmes modèles à un prix unitaire inférieur : TokLab et Runware. Sur la famille Seedance, les tarifs publiés de TokLab par token sont environ deux fois moins élevés que ceux de fal.
- Le plus grand catalogue, ou vos propres modèles : Replicate. L’annonce de l’acquisition par Cloudflare fait état de plus de 50 000 modèles.
- Surtout des LLM, avec un peu de médias : OpenRouter pour accéder aux modèles de texte de plusieurs fournisseurs, Together AI pour les modèles ouverts et la location de GPU.
- Entraînement de LoRA, déploiements privés, temps GPU brut : restez sur fal ou louez vous-même des GPU.
fal.ai : services, tarifs et conditions
Voici les conditions de fal telles qu’elles figurent dans sa documentation.
- Facturation. Les API de modèles facturent au résultat. La documentation tarifaire de fal précise : « Vous êtes facturé pour les résultats générés avec succès ». Les erreurs serveur ne sont jamais facturées et le temps passé en file d’attente est gratuit. Une requête en échec sur fal ne coûte donc déjà rien : ce n’est pas une raison de changer de plateforme.
- Expiration des crédits. fal fonctionne en prépaiement. Ses conditions d’utilisation indiquent que les crédits achetés « expireront 365 jours après la date d’achat ». Les crédits gratuits ou promotionnels expirent au bout de 90 jours.
- Requêtes simultanées. Un nouveau compte peut exécuter 2 requêtes à la fois. La limite augmente en fonction du « montant total des factures payées au cours des quatre dernières semaines », jusqu’à 40 en libre-service. Au-delà, il faut contacter l’équipe commerciale (documentation sur les limites de requêtes simultanées). Les requêtes au-delà de la limite patientent dans la file au lieu d’échouer.
- LLM. Les points de terminaison texte de fal passent par
openrouter/router: les modèles de conversation sur fal utilisent donc OpenRouter derrière l’API de fal. - GPU. fal loue aussi de la puissance de calcul : sa page de tarifs affiche un H100 à $4.50 par heure, « à partir de $2.49 ».
Il reste donc trois vraies raisons de regarder ailleurs : le prix des modèles précis que vous utilisez, la progression de la limite de requêtes simultanées pour un nouveau compte et l’expiration des crédits.
Seedance 2.0 Fast en 720p : un modèle, cinq prix
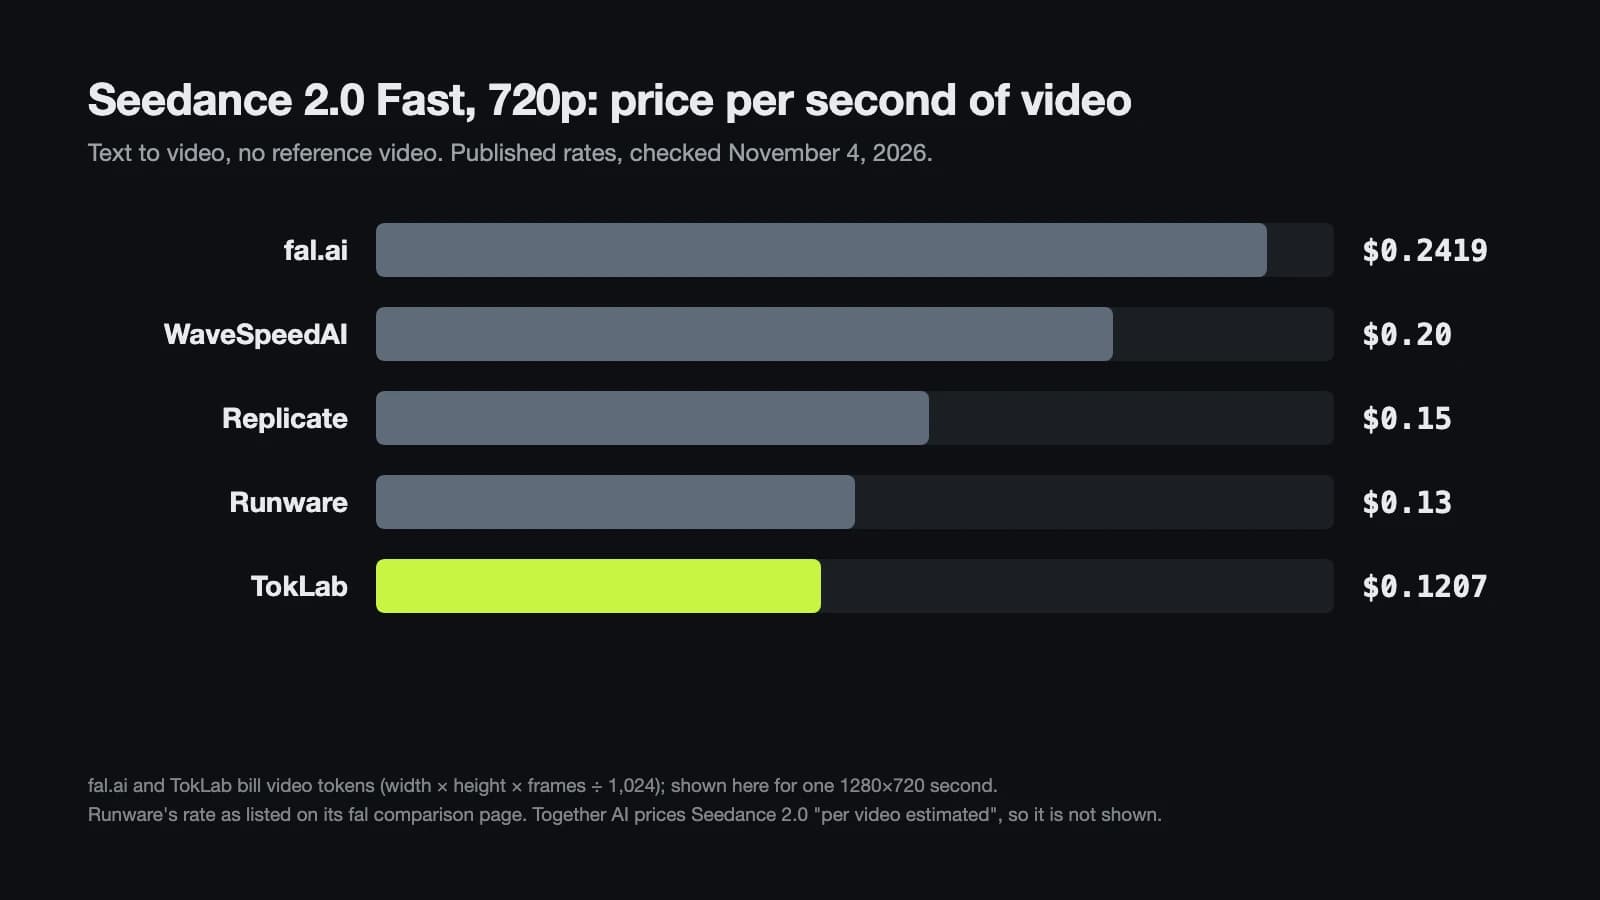
Seedance 2.0 Fast est disponible sur la plupart de ces plateformes, ce qui permet une comparaison sur une même base. Les chiffres correspondent au prix d’une seconde de vidéo en 720p générée à partir d’un prompt texte, sans vidéo de référence.
| Plateforme | 720p, par seconde | Unité de facturation |
|---|---|---|
| fal.ai | $0.2419 | tokens vidéo, $0.0112 pour 1 000 |
| WaveSpeedAI | $0.20 | seconde de vidéo générée |
| Replicate | $0.15 | seconde de vidéo générée |
| Runware | $0.13 | seconde de vidéo générée |
| TokLab | $0.1207 | tokens vidéo, $5.588 par million |
Le chiffre de Runware est celui qu’il affiche face aux $0.2419 de fal sur sa page de comparaison avec fal.
fal et TokLab facturent tous deux Seedance en tokens vidéo, calculés ainsi : largeur × hauteur × nombre d’images ÷ 1 024. Une seconde en 1280×720 à 24 images représente 21 600 tokens. C’est ainsi que le tarif de $0.0112 pour mille tokens donne le prix publié par fal : $0.2419. Le chiffre de TokLab résulte du même calcul, appliqué à son tarif.
Together AI propose aussi Seedance 2.0, mais sa page de tarifs indique « $0.16 par vidéo, estimation », sans résolution ni durée. Ce montant ne peut donc pas figurer dans un tableau de prix à la seconde.
En 480p, le classement reste le même. Le tarif par token de fal donne $0.1125 par seconde pour un clip en 16:9, contre les tarifs de WaveSpeedAI à $0.10, de Replicate à $0.07 et de TokLab à $0.0561.
fal.ai ou TokLab : comparaison des modèles communs
Voici les modèles disponibles sur les deux plateformes, au prix public de fal, pour la génération de vidéos à partir de texte ou d’images, sans vidéo de référence. Les chiffres de TokLab proviennent de ses grilles tarifaires en ligne sur toklab.ai/pricing et de la documentation de chaque modèle.
Seedance, pour 1 000 tokens vidéo
| Modèle | fal.ai | TokLab | TokLab par rapport à fal |
|---|---|---|---|
| Seedance 2.5, 480p–720p | $0.0214 | $0.010681 | −50% |
| Seedance 2.5, 1080p | $0.0234 | $0.011671 | −50% |
| Seedance 2.0, 480p–720p | $0.014 | $0.006996 | −50% |
| Seedance 2.0, 1080p | $0.014 | $0.007678 | −45% |
| Seedance 2.0 Fast | $0.0112 | $0.005588 | −50% |
| Seedance 2.0 Mini | $0.007 | $0.003729 | −47% |
Vidéo facturée à la seconde
| Modèle | fal.ai | TokLab | TokLab par rapport à fal |
|---|---|---|---|
| Grok Imagine Video 1.5, 480p | $0.08 | $0.04 | −50% |
| Grok Imagine Video 1.5, 720p | $0.14 | $0.08 | −43% |
| Veo 3.1 Fast, 1080p, audio | $0.15 | $0.1104 | −26% |
| Kling 4.0, 720p | $0.157 | $0.1425 | −9% |
| MiniMax H3 Max, 768p | $0.08 | $0.07313 | −9% |
| Veo 3.1, 1080p, audio | $0.40 | $0.368 | −8% |
Sur TokLab, les deux lignes Veo correspondent à veo-3.1-fast-official et veo-3.1-quality-official.
Images
| Modèle | fal.ai | TokLab | TokLab par rapport à fal |
|---|---|---|---|
| Nano Banana 2.1, par million de tokens de sortie image | $35.294 | $19.50 | −45% |
| GPT Image 2.5, par million de tokens de sortie image | $30.00 | $22.50 | −25% |
| FLUX 3 Image Klein, 1K, par image | $0.009 | $0.00847 | −6% |
L’écart est important sur Seedance, Grok Imagine et Nano Banana, et faible sur Kling, Veo 3.1 Quality et FLUX. Une plateforme deux fois moins chère sur un modèle peut ne gagner que quelques pour cent sur le suivant. Comparez donc les deux ou trois modèles que vous appelez réellement.
Pour deux lignes, TokLab propose une option moins chère que celle du tableau. veo-3.1-fast facture un prix fixe de $0.168 par clip de 8 secondes en dessous de la 4K, avec moins d’options que l’ID facturé à la seconde (pas de réglage pour activer ou désactiver l’audio). Et les ID à tarif fixe de GPT Image 2.5 facturent $0.021 par image, de la qualité basse à la qualité haute : moins de la moitié des $0.0528 de fal pour une image 1024×1024 en qualité haute.
Sur quels modèles fal est-il moins cher actuellement ?
fal propose des promotions sur MiniMax H3. Du 1er au 15 novembre 2026, sa page H3 Max applique une réduction de 30 % : $0.035 par seconde en 480p et $0.056 en 768p. TokLab facture $0.0457 et $0.07313, ce qui rend fal 23 % moins cher jusqu’à la fin de la promotion. À partir du 16 novembre, fal revient à ses prix publics de $0.05 et $0.08, et TokLab repasse 9 % en dessous. Même constat pour H3 Max Turbo : $0.0175 et $0.028 chez fal, contre $0.02285 et $0.03656 chez TokLab.
GPT Image 2.5 en qualité basse est un autre cas. Le prix fixe de $0.021 s’applique aussi à la qualité basse, alors que la facturation par token de fal ramène une image 1024×1024 en qualité basse à $0.0060. Si vous générez beaucoup de petites ébauches en qualité basse, la facturation par token de fal (ou l’accès -official de TokLab, facturé $22.50 par million de tokens de sortie) revient moins cher que le tarif fixe.
Combien ont coûté nos quatre requêtes Seedance ?
Le 3 novembre 2026, nous avons envoyé une requête de génération de vidéo à partir de texte à chaque modèle Seedance sur TokLab : 480p, 4:3, 4 secondes, soit un rendu de 752×560. La passerelle a facturé 39 891 tokens pour chacune, car elle compte 97 images pour 4 secondes, soit une de plus que 4 × 24.
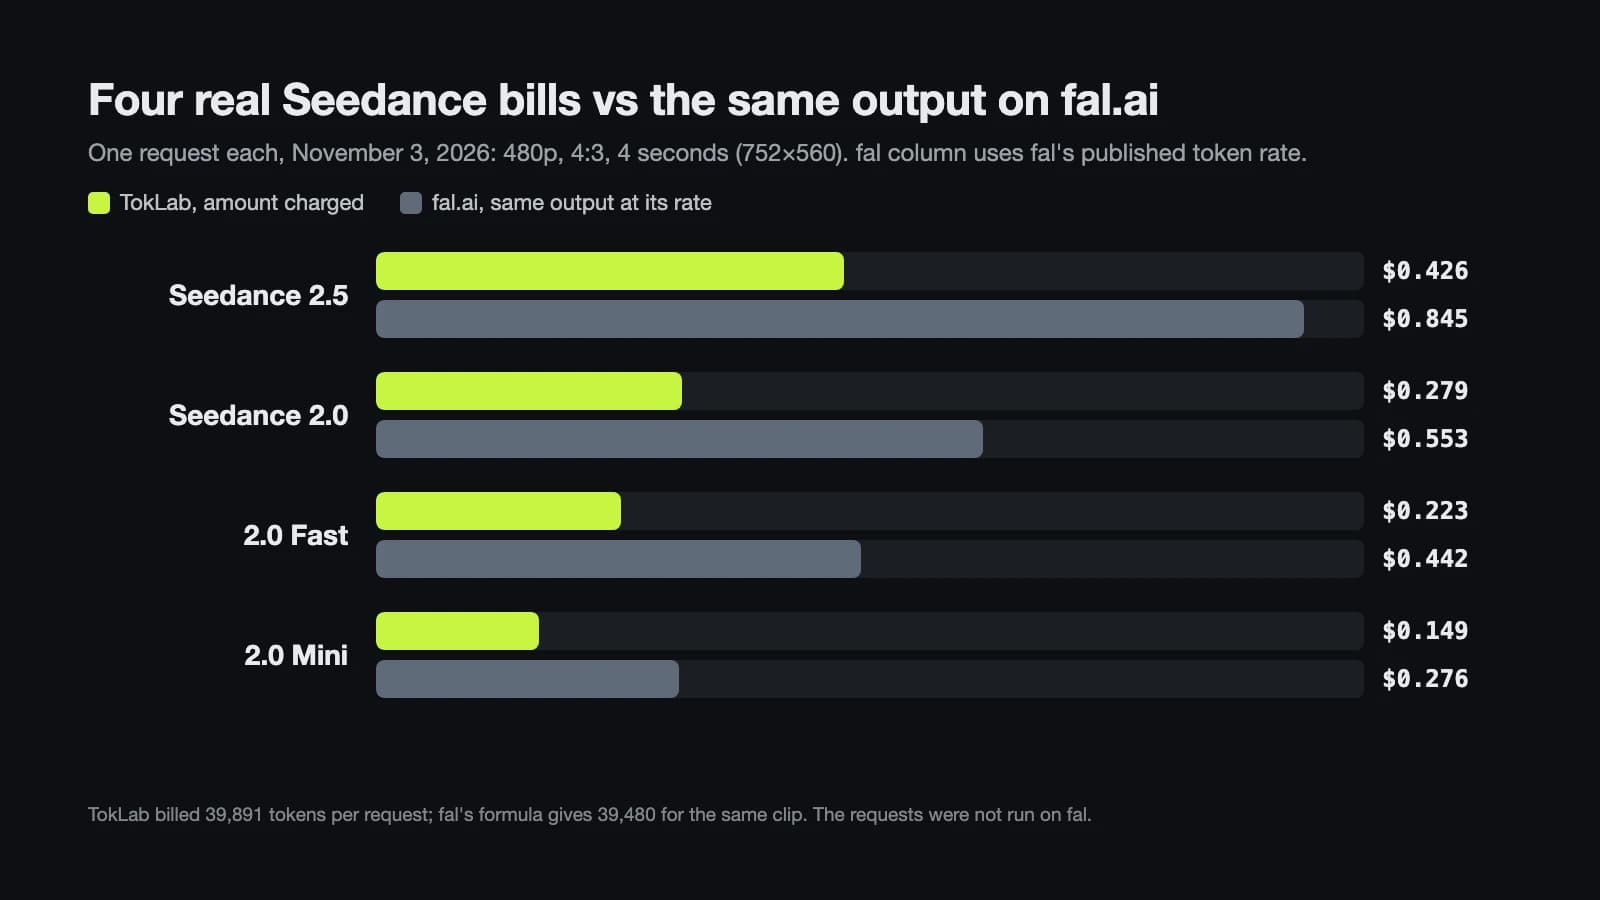
| Modèle | Montant facturé par TokLab | Même vidéo au tarif de fal | Écart |
|---|---|---|---|
| Seedance 2.5 | $0.426076 | $0.8449 | −50% |
| Seedance 2.0 | $0.279078 | $0.5527 | −50% |
| Seedance 2.0 Fast | $0.222910 | $0.4422 | −50% |
| Seedance 2.0 Mini | $0.148754 | $0.2764 | −46% |
La colonne fal utilise la formule de calcul des tokens de fal pour le même clip, soit 39 480 tokens, et le tarif publié pour chaque modèle. Nous n’avons pas exécuté ces requêtes sur fal. Chaque montant facturé par TokLab correspondait au produit du nombre de tokens par le tarif, arrondi au multiple de $0.000002 le plus proche, soit le plus petit montant facturable par le registre comptable. Un clip Mini de 5 secondes avec les mêmes paramètres a été facturé 49 761 tokens, pour $0.185558.
Nous avons répété les quatre requêtes le 4 novembre avec un autre prompt (les clips de l’image en début d’article). Chacune a de nouveau totalisé 39 891 tokens, pour le même montant que la veille. La facture dépend de la résolution, du format d’image et de la durée, pas du contenu de l’image.
Les alternatives à fal.ai en détail
TokLab
TokLab réunit dans une seule API des modèles d’image, de vidéo, d’audio et de texte, avec un solde et une clé uniques. Les tâches vidéo et image sont envoyées à /v1/videos/generations et /v1/images/generations, puis leurs résultats sont récupérés via /v1/tasks/{id}. Les modèles de texte utilisent /v1/chat/completions et /v1/responses, compatibles avec OpenAI. Sa page de modèles répertorie 44 modèles, dont Seedance 2.5 et 2.0, Kling, Veo 3.1, GPT Image 2.5, Nano Banana, Claude et GPT-6. Beaucoup sont accessibles de deux façons : à prix fixe par résultat ou via un accès -official facturé par token.
Les crédits n’expirent pas, les tâches en échec ne sont pas facturées et la recharge minimale est de $20.
Les fonctions absentes comptent tout autant. TokLab ne propose ni entraînement de LoRA, ni déploiement de modèles personnalisés, ni location de GPU. Les résultats des tâches se récupèrent par interrogation périodique : la page sur les webhooks précise que les API de tâches « ne fournissent pas de webhook public de fin de tâche ». Et 44 modèles ne représentent qu’une petite fraction des plus de 1 500 de fal.
À privilégier pour : les équipes qui utilisent à grande échelle quelques modèles populaires de vidéo et d’image, cherchent à en réduire le prix unitaire et souhaitent accéder à des LLM avec la même clé.
Replicate
Replicate possède le plus grand catalogue de cette sélection. Le 17 novembre 2025, Cloudflare a annoncé avoir conclu un accord pour acquérir Replicate, en citant plus de 50 000 modèles prêts pour la production. Les modèles officiels tels que Seedance 2.0 Fast sont facturés par seconde de vidéo générée ($0.07 en 480p, $0.15 en 720p). Les modèles communautaires et vos propres déploiements sont, eux, facturés au temps d’utilisation du matériel. La page de tarifs affiche un H100 à $0.001525 par seconde, soit $5.49 par heure.
C’est la plateforme à choisir pour une version finement ajustée destinée à un usage de niche ou un modèle de recherche absent des catalogues sélectionnés. En contrepartie, la facturation du matériel à la seconde fait dépendre le coût d’un modèle communautaire de sa durée d’exécution.
À privilégier pour : les projets qui ont besoin d’un modèle ouvert précis ou souhaitent publier le leur.
Runware
Runware exécute les modèles sur sa propre infrastructure d’inférence et se positionne directement face à fal. Sa page de comparaison avec fal met 63 modèles en parallèle, annonce une économie moyenne de 43 % par modèle et une économie maximale de 92 % sur un modèle (FLUX.1 [dev] SRPO, à $0.0019 contre $0.025 par image). Ce sont les chiffres de Runware lui-même ; la page permet de vérifier votre modèle avant de vous inscrire.
À privilégier pour : les usages principalement centrés sur l’image avec des modèles ouverts. Les variantes de FLUX et de Qwen-Image occupent la plupart des premières places de son tableau d’économies.
WaveSpeedAI
WaveSpeedAI héberge bon nombre des mêmes modèles vidéo, avec des prix à la seconde selon la résolution. Sa fiche Seedance 2.0 Fast affiche $0.10 par seconde en 480p et $0.20 en 720p, avec les totaux pour 5, 10 et 15 secondes à côté de chaque tarif. En 720p, c’est 17 % de moins que fal, un écart plus faible que chez Replicate, Runware ou TokLab.
À privilégier pour : les équipes vidéo qui veulent lire directement les prix à la seconde dans un tableau.
Together AI
Together AI est un cloud d’inférence pour modèles ouverts. Sa page de tarifs présente d’abord les modèles de texte serverless, puis les points de terminaison dédiés et la location de GPU : un HGX H100 coûte $1.99 par heure GPU en mode préemptible ou $3.99 à la demande. Elle répertorie aussi des modèles de médias, dont Seedance 2.5 et 2.0, mais affiche un prix « par vidéo, estimation », ce qui complique la planification d’un budget vidéo.
À privilégier pour : les produits centrés sur les LLM qui ont aussi besoin d’un peu d’image ou de vidéo.
OpenRouter
OpenRouter permet d’utiliser une seule clé API pour accéder aux modèles de texte de nombreux fournisseurs et propose désormais aussi une API de génération vidéo asynchrone. C’est un routeur : il n’héberge pas de modèles, ne les entraîne pas et ne loue pas de GPU. Les points de terminaison de conversation de fal passent eux-mêmes par OpenRouter.
À privilégier pour : l’accès aux modèles de texte de nombreux fournisseurs avec une seule clé et une seule facture.
Louer vous-même des GPU
Si votre volume est régulier, un GPU facturé à l’heure peut revenir moins cher que n’importe quel tarif au résultat, puisque vous payez la machine et non le résultat. Les points de comparaison sont le H100 de fal (à partir de $2.49, jusqu’à $4.50 par heure), celui de Together ($1.99 en mode préemptible, $3.99 à la demande) et celui de Replicate ($5.49). Le prix à payer, c’est tout le travail qu’une API hébergée fait pour vous : charger les poids, gérer les démarrages à froid, adapter la capacité et maintenir la machine occupée.
Quand vaut-il mieux rester sur fal.ai ?
fal est le meilleur choix si vous entraînez des LoRA, déployez des modèles privés ou finement ajustés, avez besoin de modèles 3D ou de synthèse vocale (TokLab ne propose ni l’un ni l’autre), ou dépendez de sa file d’attente et de ses webhooks. Son catalogue de plus de 1 500 modèles est aussi difficile à égaler si vous changez souvent de modèle. Et jusqu’au 15 novembre 2026 inclus, c’est la plateforme la moins chère pour utiliser MiniMax H3 Max et H3 Max Turbo.
Que vérifier avant de changer de plateforme ?
- Listez les points de terminaison que vous appelez et leur volume mensuel. Chiffrez-les sur chaque plateforme envisagée, avec vos résolutions et durées réelles. Une économie de 50 % sur un modèle rarement appelé vaut moins que 9 % sur votre modèle principal.
- Établissez la correspondance des ID de modèles et des corps de requêtes. Le
bytedance/seedance-2.0/fast/text-to-videode fal devientdreamina-seedance-2-0-fastsur TokLab, et la structure de la requête diffère : Seedance sur TokLab attend le tableaucontentde ByteDance. - Remplacez les webhooks si vous les utilisez. Sur TokLab, vous interrogez périodiquement
GET /v1/tasks/{id}jusqu’à obtenircompletedoufailed. - Vérifiez le décompte des images. La vidéo facturée par token repose sur le nombre d’images, et les fournisseurs peuvent compter une image de plus ou de moins par clip. Cela représente environ 1 % sur un clip de 4 secondes, mais l’écart apparaît au rapprochement des factures.
- Épuisez d’abord vos crédits fal. Les crédits achetés y expirent 365 jours après l’achat.
Questions fréquentes
Quelle alternative à fal.ai coûte moins cher pour Seedance ?
TokLab publie des tarifs par token environ deux fois moins élevés que ceux de fal pour Seedance 2.5, 2.0, Fast et Mini. Nos quatre requêtes de test du 3 novembre 2026 ont été facturées 46 % à 50 % moins cher que les mêmes vidéos aux tarifs de fal. Replicate et Runware affichent aussi Seedance 2.0 Fast en 720p à un prix inférieur à celui de fal.
fal.ai facture-t-il les requêtes en échec ?
Non. fal facture uniquement les résultats générés avec succès ; les requêtes qui échouent à cause d’une erreur serveur ne sont pas facturées. TokLab fonctionne de la même manière.
Les crédits fal.ai ont-ils une date d’expiration ?
Oui. Selon les conditions d’utilisation de fal, les crédits achetés expirent 365 jours après l’achat, et les crédits gratuits ou promotionnels au bout de 90 jours. Les soldes TokLab n’expirent pas.
Replicate est-il moins cher que fal.ai ?
Cela dépend du modèle. Chez Replicate, Seedance 2.0 Fast coûte $0.15 par seconde en 720p, contre un tarif fal de $0.2419. Pour les modèles communautaires facturés au temps GPU, le prix dépend de la durée d’exécution : testez avec vos propres données d’entrée.
Peut-on utiliser une seule clé API pour les LLM et la vidéo ?
Sur TokLab, oui : les modèles de texte utilisent les points de terminaison compatibles avec OpenAI et les modèles de médias ceux des tâches, avec un solde commun. fal propose aussi des modèles de conversation, acheminés via OpenRouter.
Conclusion
Pour la plupart des équipes, la bonne alternative à fal.ai est celle qui coûte le moins cher sur les deux ou trois modèles les plus utilisés. Sur la famille Seedance et Grok Imagine Video, les tarifs de TokLab sont de 43 % à 50 % inférieurs à ceux de fal. Sur Kling, Veo 3.1 Quality et FLUX, l’écart reste inférieur à 10 %, et sur MiniMax H3 Max, fal est moins cher jusqu’au 15 novembre. Chiffrez vos propres usages à partir des tableaux ci-dessus, puis consultez les tarifs actuels avant de rediriger votre trafic.