Alternative a fal.ai: stessi modelli, prezzi a confronto
Sei alternative a fal.ai a confronto sugli stessi modelli: tariffe pubblicate verificate il 4 novembre 2026 e quattro addebiti reali di Seedance.
Leggi in Markdownfal.ai è un servizio API che ospita modelli per immagini, video e audio. La homepage elenca oltre 1.500 modelli di contenuti generativi e paghi per ogni risultato: per immagine, per megapixel o per secondo di video. Per scegliere un'alternativa a fal.ai devi partire dal modello che usi già, da quanto costa altrove e da ciò a cui rinunceresti cambiando piattaforma.
Questo confronto parte quindi dai prezzi. Tutte le cifre che seguono provengono dalle pagine dei prezzi o dei modelli delle singole piattaforme, verificate il 4 novembre 2026, con il link accanto. TokLab è il nostro prodotto ed è incluso nell'elenco. Dove fal costa meno, le tabelle lo indicano.
Quale alternativa scegliere
- Stessi modelli, prezzo unitario più basso: TokLab e Runware. Per la famiglia Seedance, le tariffe a token pubblicate da TokLab sono circa la metà di quelle di fal.
- Il catalogo più ampio, o i tuoi modelli: Replicate. L'annuncio dell'acquisizione da parte di Cloudflare cita oltre 50.000 modelli.
- Soprattutto LLM, con qualche modello multimediale: OpenRouter per instradare le richieste tra servizi di modelli di testo, Together AI per i modelli aperti e il noleggio di GPU.
- Addestramento LoRA, deployment privati, tempo GPU: resta su fal, oppure noleggia direttamente le GPU.
Cosa offre fal.ai e quanto costa
Ecco le condizioni di fal, come riportate nella sua documentazione.
- Addebiti. Le API dei modelli si pagano per risultato. La documentazione sui prezzi di fal dice: «Ti vengono addebitati i risultati generati con successo». Gli errori del server non vengono mai addebitati e il tempo in coda è gratuito. Su fal una richiesta fallita non costa già nulla: non è quindi un motivo per cambiare.
- Scadenza del credito. fal usa un sistema prepagato. Le sue condizioni di servizio stabiliscono che i crediti acquistati «scadranno dopo 365 giorni dalla data di acquisto», mentre quelli gratuiti o promozionali scadono dopo 90 giorni.
- Concorrenza. Un nuovo account può eseguire 2 richieste contemporaneamente. Il limite aumenta in base all'«importo totale delle fatture pagate nelle ultime quattro settimane», fino a 40 senza intervento commerciale; oltre questa soglia devi contattare il reparto vendite (documentazione sui limiti di concorrenza). Le richieste che superano il limite attendono in coda anziché fallire.
- LLM. Gli endpoint di testo di fal si trovano sotto
openrouter/router: i modelli di chat su fal passano quindi da OpenRouter attraverso l'API di fal. - GPU. fal noleggia anche risorse di calcolo: una H100 costa di listino $4.50 all'ora, o «a partire da $2.49,» secondo la sua pagina dei prezzi.
Restano tre motivi concreti per valutare altre piattaforme: il prezzo dei modelli che usi, i limiti di concorrenza iniziali e il credito che scade.
Un modello, cinque prezzi: Seedance 2.0 Fast a 720p
Seedance 2.0 Fast è disponibile sulla maggior parte di queste piattaforme e si presta quindi a un confronto diretto. La cifra indica il prezzo di un secondo di video a 720p generato da un prompt di testo, senza video di riferimento.
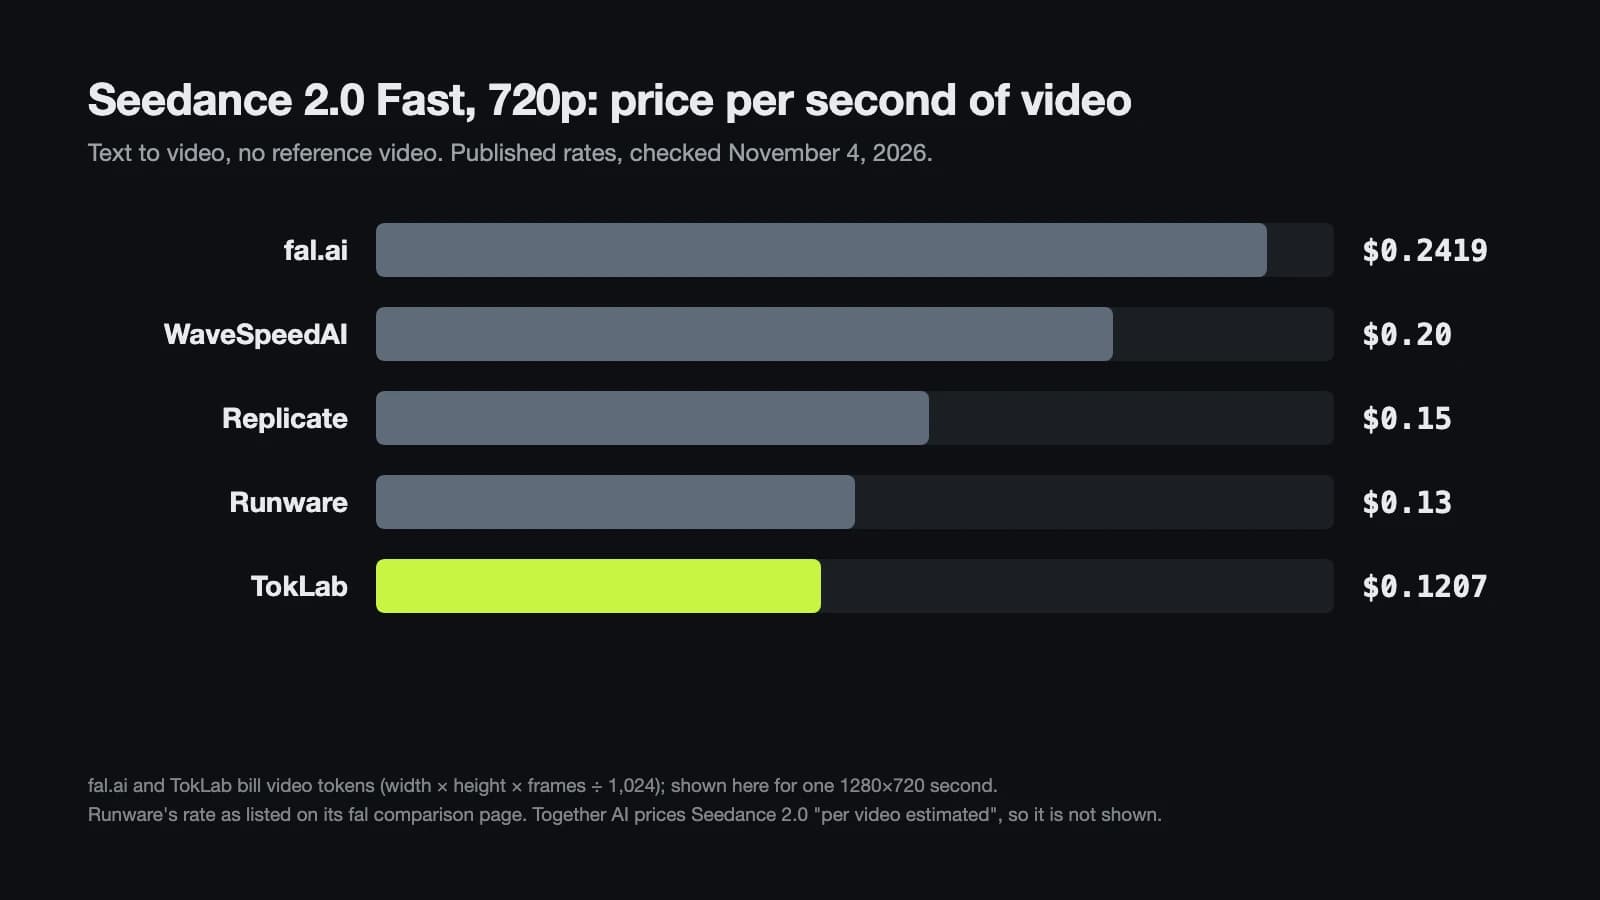
| Piattaforma | 720p, al secondo | Unità di addebito |
|---|---|---|
| fal.ai | $0.2419 | token video, $0.0112 per 1.000 |
| WaveSpeedAI | $0.20 | secondo di video generato |
| Replicate | $0.15 | secondo di video generato |
| Runware | $0.13 | secondo di video generato |
| TokLab | $0.1207 | token video, $5.588 per milione |
La cifra di Runware è quella riportata nella sua pagina di confronto accanto al prezzo di fal, $0.2419.
Sia fal sia TokLab addebitano Seedance in base ai token video, calcolati come larghezza × altezza × fotogrammi ÷ 1.024. Un secondo a 1280×720 con 24 fotogrammi equivale a 21.600 token: così i $0.0112 per mille diventano il prezzo pubblicato da fal, $0.2419. La cifra di TokLab deriva dallo stesso calcolo applicato alla sua tariffa.
Anche Together AI offre Seedance 2.0, ma la sua pagina dei prezzi riporta «$0.16 per video, stimati» senza specificare risoluzione o durata: non può quindi rientrare in una tabella di prezzi al secondo.
A 480p l'ordine resta lo stesso. La tariffa a token di fal equivale a $0.1125 al secondo per una clip in 16:9; WaveSpeedAI indica $0.10, Replicate $0.07 e TokLab $0.0561.
fal.ai e TokLab: prezzi dei modelli disponibili su entrambe
Questi sono i modelli comuni alle due piattaforme, confrontati con il prezzo di listino di fal, per video generati da testo o immagini senza video di riferimento. Le cifre di TokLab provengono dalle tabelle aggiornate su toklab.ai/pricing e dalla pagina di documentazione di ciascun modello.
Seedance, per 1.000 token video
| Modello | fal.ai | TokLab | TokLab rispetto a fal |
|---|---|---|---|
| Seedance 2.5, 480p–720p | $0.0214 | $0.010681 | −50% |
| Seedance 2.5, 1080p | $0.0234 | $0.011671 | −50% |
| Seedance 2.0, 480p–720p | $0.014 | $0.006996 | −50% |
| Seedance 2.0, 1080p | $0.014 | $0.007678 | −45% |
| Seedance 2.0 Fast | $0.0112 | $0.005588 | −50% |
| Seedance 2.0 Mini | $0.007 | $0.003729 | −47% |
Video con addebito al secondo
| Modello | fal.ai | TokLab | TokLab rispetto a fal |
|---|---|---|---|
| Grok Imagine Video 1.5, 480p | $0.08 | $0.04 | −50% |
| Grok Imagine Video 1.5, 720p | $0.14 | $0.08 | −43% |
| Veo 3.1 Fast, 1080p, audio | $0.15 | $0.1104 | −26% |
| Kling 4.0, 720p | $0.157 | $0.1425 | −9% |
| MiniMax H3 Max, 768p | $0.08 | $0.07313 | −9% |
| Veo 3.1, 1080p, audio | $0.40 | $0.368 | −8% |
Su TokLab le due righe Veo corrispondono a veo-3.1-fast-official e veo-3.1-quality-official.
Immagini
| Modello | fal.ai | TokLab | TokLab rispetto a fal |
|---|---|---|---|
| Nano Banana 2.1, per 1 milione di token di output immagine | $35.294 | $19.50 | −45% |
| GPT Image 2.5, per 1 milione di token di output immagine | $30.00 | $22.50 | −25% |
| FLUX 3 Image Klein, 1K, per immagine | $0.009 | $0.00847 | −6% |
Il divario è ampio per Seedance, Grok Imagine e Nano Banana, ridotto per Kling, Veo 3.1 Quality e FLUX. Una piattaforma che costa la metà su un modello può differire solo di pochi punti percentuali su un altro: calcola quindi il costo dei due o tre modelli che chiami davvero.
Per due righe esiste su TokLab una modalità di accesso più economica di quella in tabella. veo-3.1-fast applica una tariffa fissa di $0.168 per clip di 8 secondi sotto il 4K, con meno opzioni rispetto all'ID con addebito al secondo (non puoi attivare o disattivare l'audio). E gli ID a tariffa fissa di GPT Image 2.5 costano $0.021 per immagine, dalla qualità bassa a quella alta: meno della metà dei $0.0528 di fal per un'immagine 1024×1024 in qualità alta.
Quando fal costa meno
fal ha promozioni attive su MiniMax H3. Dal 1° al 15 novembre 2026 la sua pagina H3 Max applica uno sconto del 30%: $0.035 al secondo a 480p e $0.056 a 768p. TokLab addebita $0.0457 e $0.07313, quindi fal costa il 23% in meno fino alla fine della promozione. Dal 16 novembre il prezzo di listino di fal torna a $0.05 e $0.08, e TokLab torna a costare il 9% in meno. Per H3 Max Turbo vale lo stesso: $0.0175 e $0.028 su fal contro $0.02285 e $0.03656 su TokLab.
Un altro caso è GPT Image 2.5 in qualità bassa. La tariffa fissa di $0.021 si applica anche alla qualità bassa, mentre con l'addebito a token di fal un'immagine 1024×1024 in qualità bassa costa $0.0060. Se generi molte piccole bozze in qualità bassa, l'addebito a token di fal (o la modalità a token -official di TokLab, a $22.50 per milione di token di output) costa meno della tariffa fissa.
Quanto costano quattro richieste reali a Seedance
Il 3 novembre 2026 abbiamo inviato su TokLab una richiesta di generazione video da testo a ciascun modello Seedance: 480p, 4:3, 4 secondi, con un output di 752×560. Il gateway ha addebitato 39.891 token per ciascuna richiesta, perché conta 97 fotogrammi per 4 secondi, uno in più di 4 × 24.
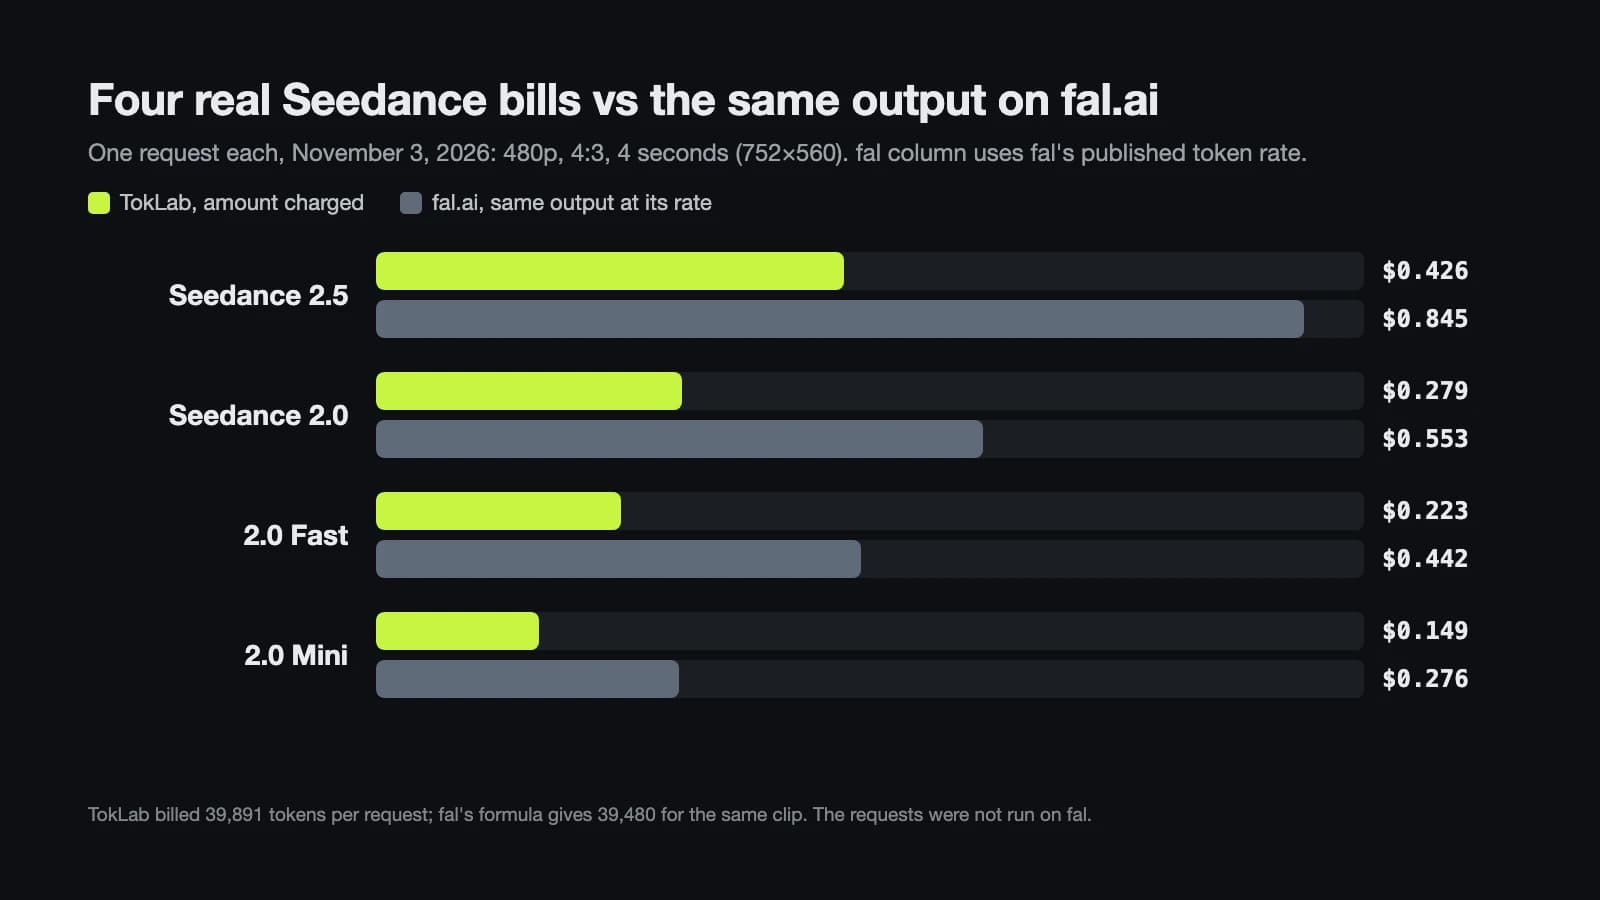
| Modello | Addebito TokLab | Stesso risultato alla tariffa di fal | Differenza |
|---|---|---|---|
| Seedance 2.5 | $0.426076 | $0.8449 | −50% |
| Seedance 2.0 | $0.279078 | $0.5527 | −50% |
| Seedance 2.0 Fast | $0.222910 | $0.4422 | −50% |
| Seedance 2.0 Mini | $0.148754 | $0.2764 | −46% |
La colonna di fal usa la formula dei token di fal per la stessa clip, che restituisce 39.480 token, e la tariffa pubblicata per ciascun modello. Non abbiamo eseguito queste richieste su fal. Ogni addebito di TokLab era pari a token × tariffa, arrotondato al multiplo di $0.000002 più vicino, il minimo importo addebitabile dal registro contabile. Una clip Mini di 5 secondi con le stesse impostazioni ha comportato un addebito di 49.761 token, per $0.185558.
Abbiamo ripetuto le quattro richieste il 4 novembre con un prompt diverso (le clip nell'immagine in apertura). Ciascuna ha restituito 39.891 token con lo stesso addebito del giorno prima. Il costo dipende da risoluzione, formato e durata, non da ciò che compare nell'inquadratura.
Le alternative a fal.ai, una per una
TokLab
TokLab è un'unica API per modelli di immagini, video, audio e testo, con un credito e una chiave. Le attività video e immagini vengono inviate a /v1/videos/generations e /v1/images/generations e i risultati si recuperano da /v1/tasks/{id}; i modelli di testo usano /v1/chat/completions e /v1/responses, compatibili con OpenAI. La sua pagina dei modelli elenca 44 modelli, tra cui Seedance 2.5 e 2.0, Kling, Veo 3.1, GPT Image 2.5, Nano Banana, Claude e GPT-6. Molti offrono due modalità di accesso: una a prezzo fisso per risultato e una -official con addebito a token.
Il credito non scade, le attività fallite non vengono addebitate e la ricarica minima è di $20.
Conta altrettanto ciò che manca. Non sono disponibili addestramento LoRA, deployment di modelli personalizzati o noleggio di GPU. I risultati delle attività si recuperano tramite polling: la pagina sui webhook dice che le API delle attività «non forniscono un webhook pubblico di completamento». E 44 modelli sono una piccola parte degli oltre 1.500 di fal.
Ideale per: team che usano pochi modelli video e di immagini diffusi, ma con volumi elevati, vogliono pagarli meno per unità e usare gli LLM con la stessa chiave.
Replicate
Replicate ha il catalogo più ampio del gruppo. Il 17 novembre 2025 Cloudflare ha annunciato di aver raggiunto un accordo per acquisire Replicate, citando oltre 50.000 modelli pronti per la produzione. I modelli ufficiali come Seedance 2.0 Fast hanno un prezzo per secondo di output ($0.07 a 480p, $0.15 a 720p). I modelli della community e i tuoi deployment si pagano invece in base al tempo di utilizzo dell'hardware: la pagina dei prezzi indica $0.001525 al secondo per una H100, ovvero $5.49 all'ora.
È la piattaforma a cui rivolgersi per un modello adattato a un uso di nicchia o un modello di ricerca che non compare nei cataloghi selezionati. Il compromesso è che, pagando l'hardware al secondo, il costo di un modello della community dipende dal tempo di esecuzione.
Ideale per: progetti che richiedono un modello aperto specifico o vogliono pubblicarne uno proprio.
Runware
Runware esegue i modelli sulla propria infrastruttura di inferenza e si propone direttamente come concorrente di fal. La sua pagina di confronto con fal mette a confronto 63 modelli, dichiara un risparmio medio del 43% per modello e un risparmio massimo del 92% su un singolo modello (FLUX.1 [dev] SRPO, $0.0019 contro $0.025 per immagine). Sono cifre di Runware stessa; la pagina è utile per verificare il tuo modello prima di registrarti.
Ideale per: carichi di lavoro prevalentemente basati su immagini e modelli aperti. Le varianti di FLUX e Qwen-Image occupano gran parte delle prime posizioni nella sua tabella dei risparmi.
WaveSpeedAI
WaveSpeedAI ospita molti degli stessi modelli video e applica prezzi al secondo in base alla risoluzione. Nella sua pagina del modello, Seedance 2.0 Fast costa $0.10 al secondo a 480p e $0.20 a 720p, con i totali per 5, 10 e 15 secondi già calcolati accanto a ogni tariffa. A 720p costa il 17% in meno di fal: un divario inferiore a quello di Replicate, Runware o TokLab.
Ideale per: team video che vogliono prezzi al secondo consultabili direttamente in tabella.
Together AI
Together AI è una piattaforma cloud di inferenza per modelli aperti. La pagina dei prezzi presenta prima i modelli di testo serverless, poi gli endpoint dedicati e il noleggio di GPU: una HGX H100 costa $1.99 per ora GPU con istanze interrompibili o $3.99 on demand. Elenca anche modelli multimediali, tra cui Seedance 2.5 e 2.0, ma ne indica il costo «per video, stimato», rendendo difficile pianificare un budget per i video.
Ideale per: prodotti incentrati sugli LLM che richiedono anche qualche funzione di generazione di immagini o video.
OpenRouter
OpenRouter consente di usare un'unica chiave API per accedere ai modelli di testo di molte aziende e ora offre anche un'API asincrona di generazione video. È un servizio di instradamento: non ospita modelli, non li addestra e non noleggia GPU. Anche gli endpoint di chat di fal passano attraverso OpenRouter.
Ideale per: usare modelli di testo di molte aziende con una sola chiave e un'unica fattura.
Noleggiare direttamente le GPU
Se i tuoi volumi sono costanti, una GPU pagata a ore può costare meno di qualsiasi prezzo per risultato, perché paghi la macchina anziché l'output. I riferimenti sono le H100 di fal (da $2.49 a $4.50 all'ora), Together ($1.99 con istanze interrompibili, $3.99 on demand) e Replicate ($5.49). Il costo è farti carico di tutto ciò che un'API gestita fa per te: caricare i pesi, gestire gli avvii a freddo, scalare le risorse e tenere occupata la macchina.
Quando conviene restare su fal.ai
fal è la scelta migliore se addestri LoRA, distribuisci modelli privati o adattati tramite fine-tuning, ti servono modelli 3D o di sintesi vocale (TokLab non offre né gli uni né gli altri), oppure dipendi dalla sua coda e dai suoi webhook. Anche il catalogo di oltre 1.500 modelli è difficile da eguagliare se cambi spesso modello. E fino al 15 novembre 2026 è la piattaforma più economica per usare MiniMax H3 Max e H3 Max Turbo.
Cosa controllare prima di cambiare piattaforma
- Elenca gli endpoint che chiami e i relativi volumi mensili. Calcolane il costo su ogni piattaforma candidata, usando risoluzione e durata effettive. Risparmiare il 50% su un modello che chiami di rado vale meno di un 9% sul tuo modello principale.
- Individua gli ID dei modelli e i corpi delle richieste corrispondenti.
bytedance/seedance-2.0/fast/text-to-videodi fal èdreamina-seedance-2-0-fastsu TokLab e la struttura della richiesta cambia: Seedance su TokLab usa l'arraycontentdi ByteDance. - Sostituisci i webhook, se li usi. Su TokLab esegui il polling di
GET /v1/tasks/{id}finché lo stato non ècompletedofailed. - Verifica come vengono contati i fotogrammi. I video addebitati a token si basano sul numero di fotogrammi e tra servizi può esserci una differenza di un fotogramma per clip. Su una clip di 4 secondi è circa l'1%, ma emerge nella riconciliazione degli addebiti.
- Esaurisci prima il credito su fal. Il credito acquistato scade dopo 365 giorni dall'acquisto.
Domande frequenti
Quale alternativa a fal.ai costa meno per Seedance?
TokLab. Le sue tariffe a token pubblicate per Seedance sono circa la metà di quelle di fal per 2.5, 2.0, Fast e Mini. Le nostre quattro richieste di prova del 3 novembre 2026 hanno comportato addebiti dal 46% al 50% inferiori al costo degli stessi risultati alle tariffe di fal. Anche Replicate e Runware indicano prezzi di Seedance 2.0 Fast a 720p inferiori a quelli di fal.
fal.ai addebita le richieste fallite?
No. fal addebita solo i risultati generati con successo e non addebita le richieste che falliscono per un errore del server. TokLab funziona allo stesso modo.
I crediti di fal.ai scadono?
Sì. Secondo le condizioni di servizio di fal, i crediti acquistati scadono dopo 365 giorni dall'acquisto e quelli gratuiti o promozionali dopo 90 giorni. Il credito su TokLab non scade.
Replicate costa meno di fal.ai?
Dipende dal modello. Seedance 2.0 Fast su Replicate costa $0.15 al secondo a 720p contro i $0.2419 di fal. Per i modelli della community addebitati in base al tempo GPU, il prezzo dipende dalla durata dell'esecuzione: fai quindi una prova con i tuoi input.
Posso usare una sola chiave API per LLM e video?
Su TokLab sì: i modelli di testo usano gli endpoint compatibili con OpenAI e quelli multimediali gli endpoint delle attività, tutti con un unico credito. Anche fal offre modelli di chat, instradati attraverso OpenRouter.
Come scegliere in base ai tuoi volumi
Per la maggior parte dei team, l'alternativa a fal.ai giusta è quella che costa meno sui due o tre modelli più usati. Per la famiglia Seedance e Grok Imagine Video, le tariffe di TokLab sono dal 43% al 50% inferiori a quelle di fal. Su Kling, Veo 3.1 Quality e FLUX il divario è inferiore al 10%, mentre su MiniMax H3 Max fal costa meno fino al 15 novembre. Calcola il costo del tuo carico di lavoro con le tabelle qui sopra, poi controlla le tariffe aggiornate prima di spostare il traffico.