Alternativas a fal.ai: los mismos modelos, con sus precios frente a frente
Comparamos seis alternativas a fal.ai con tarifas publicadas, revisadas el 4 de noviembre de 2026, y cuatro cargos reales de Seedance.
Leer en Markdownfal.ai es una API alojada para modelos de imagen, vídeo y audio. Su página de inicio anuncia más de 1.500 modelos de generación multimedia y pagas por resultado: por imagen, por megapíxel o por segundo de vídeo. Para elegir una alternativa a fal.ai, lo que cuenta es el modelo que ya usas, cuánto cuesta en otras plataformas y a qué tendrías que renunciar si cambias.
Por eso, esta comparativa parte de los precios. Todas las cifras que aparecen a continuación proceden de las páginas de precios o de modelos de cada plataforma, revisadas el 4 de noviembre de 2026, con el enlace al lado. TokLab es nuestro producto y está en la lista. Cuando fal sale más barato, las tablas lo reflejan.
Qué alternativa elegir según lo que necesitas
- Los mismos modelos a un menor precio por unidad: TokLab y Runware. En la familia Seedance, las tarifas publicadas por token de TokLab son aproximadamente la mitad de las de fal.
- El catálogo más amplio o tus propios modelos: Replicate. El anuncio de adquisición de Cloudflare cifra su catálogo en más de 50.000 modelos.
- Principalmente LLM, con algo de contenido multimedia: OpenRouter para dirigir las solicitudes de texto a distintos proveedores; Together AI para modelos abiertos y alquiler de GPU.
- Entrenamiento de LoRA, despliegues privados y tiempo de GPU sin más servicios: quédate en fal o alquila las GPU por tu cuenta.
Qué ofrece fal.ai y cuánto cuesta
Estas son las condiciones de fal según su propia documentación.
- Facturación. Las API de modelos cobran por resultado. La documentación de precios de fal dice: «Se te facturan los resultados generados correctamente». Los errores del servidor nunca se cobran y el tiempo en cola es gratuito. Una solicitud fallida ya cuesta cero en fal, así que eso no es un motivo para cambiar.
- Caducidad de los créditos. fal funciona con prepago. Sus condiciones de servicio establecen que los créditos comprados «caducarán a los 365 días de la fecha de compra», y que los créditos gratuitos o promocionales caducan a los 90 días.
- Concurrencia. Una cuenta nueva puede ejecutar 2 solicitudes a la vez. El límite aumenta en función del «importe total de las facturas pagadas en las últimas cuatro semanas», hasta 40 sin pasar por ventas; para superar ese límite, tienes que contactar con el equipo comercial (documentación sobre concurrencia). Las solicitudes que superan el límite esperan en la cola en vez de fallar.
- LLM. Los endpoints de texto de fal están bajo
openrouter/router, así que los modelos de chat de fal usan OpenRouter a través de la API de fal. - GPU. fal también alquila capacidad de cómputo: una H100 figura a $4.50 por hora, «desde tan solo $2.49,» en su página de precios.
Quedan tres motivos concretos para buscar otras opciones: el precio de los modelos que usas, cómo aumenta la concurrencia de una cuenta nueva y la caducidad del saldo.
Un modelo, cinco precios: Seedance 2.0 Fast a 720p
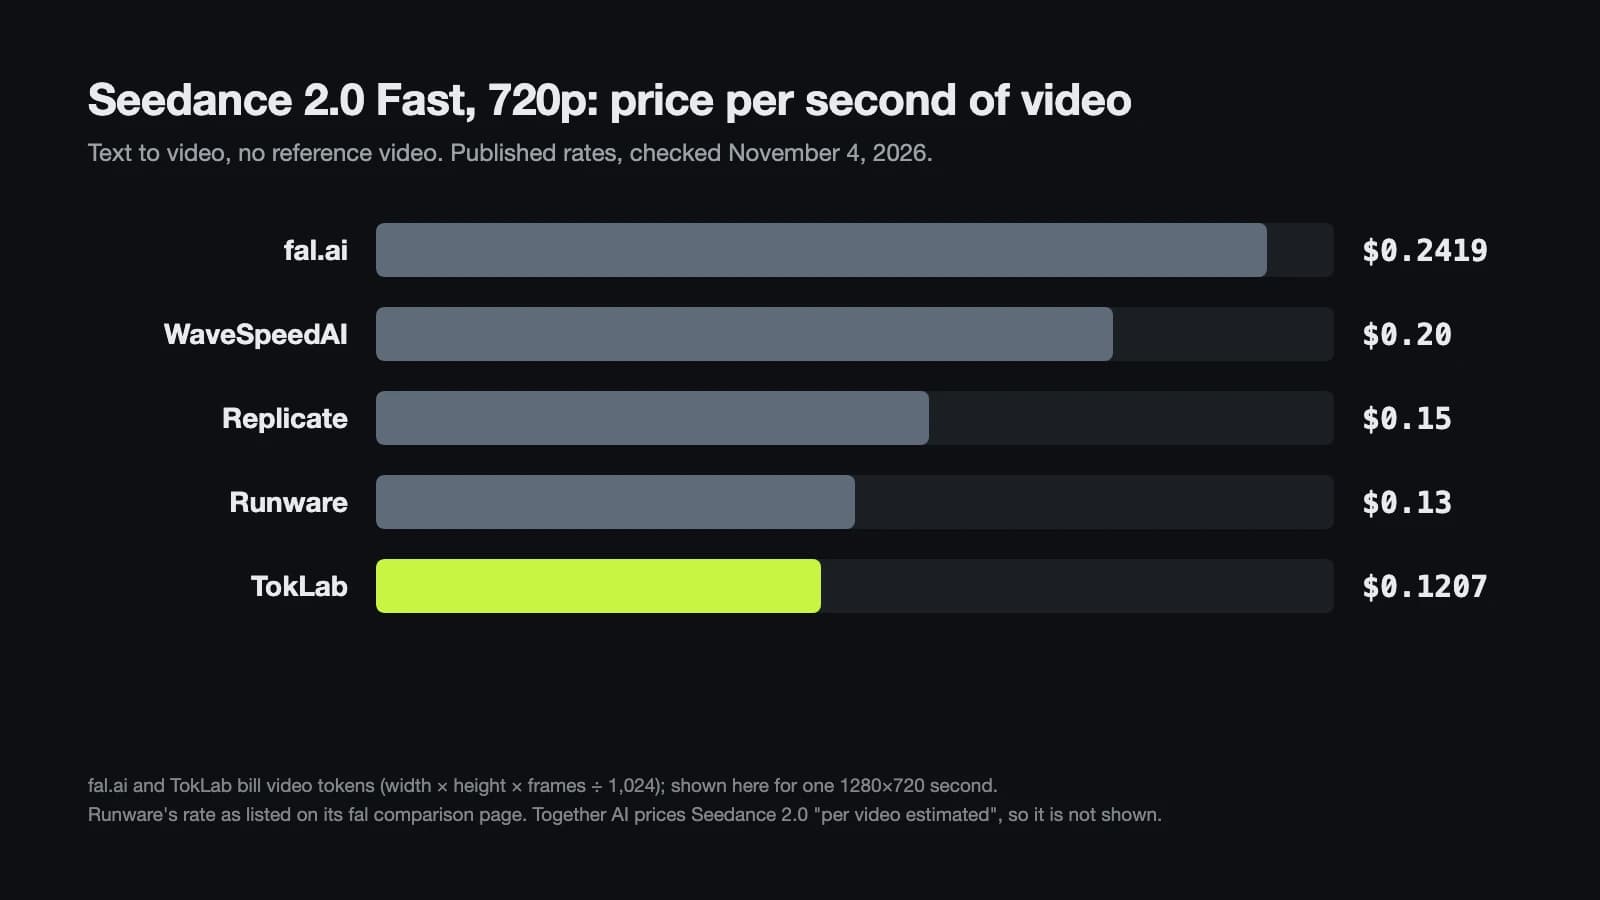
Seedance 2.0 Fast está disponible en la mayoría de estas plataformas, así que permite comparar el mismo caso. La cifra corresponde a un segundo de vídeo a 720p generado a partir de texto, sin vídeo de referencia.
| Plataforma | 720p, por segundo | Unidad de facturación |
|---|---|---|
| fal.ai | $0.2419 | tokens de vídeo, $0.0112 por 1.000 |
| WaveSpeedAI | $0.20 | segundo de vídeo generado |
| Replicate | $0.15 | segundo de vídeo generado |
| Runware | $0.13 | segundo de vídeo generado |
| TokLab | $0.1207 | tokens de vídeo, $5.588 por millón |
La cifra de Runware es la que publica en su página de comparación con fal, junto a la de fal: $0.2419.
Tanto fal como TokLab facturan Seedance por tokens de vídeo, calculados como anchura × altura × fotogramas ÷ 1.024. Un segundo a 1280×720 y 24 fotogramas equivale a 21.600 tokens. Así se pasa de $0.0112 por mil tokens a los $0.2419 que publica fal. La cifra de TokLab aplica el mismo cálculo a su tarifa.
Together AI también ofrece Seedance 2.0, pero su página de precios indica «$0.16 por vídeo, estimado», sin especificar resolución ni duración, por lo que no puede entrar en una tabla de precios por segundo.
A 480p se mantiene el orden. La tarifa por token de fal equivale a $0.1125 por segundo para un clip en 16:9; WaveSpeedAI publica $0.10, Replicate $0.07 y TokLab $0.0561.
fal.ai frente a TokLab: precios de los modelos que comparten
Estos son los modelos que ofrecen ambas plataformas, con el precio de lista de fal para generar vídeo a partir de texto o imagen, sin vídeo de referencia. Las cifras de TokLab proceden de sus tablas de precios vigentes en toklab.ai/pricing y de la documentación de cada modelo.
Seedance, por 1.000 tokens de vídeo
| Modelo | fal.ai | TokLab | TokLab frente a fal |
|---|---|---|---|
| Seedance 2.5, 480p–720p | $0.0214 | $0.010681 | −50% |
| Seedance 2.5, 1080p | $0.0234 | $0.011671 | −50% |
| Seedance 2.0, 480p–720p | $0.014 | $0.006996 | −50% |
| Seedance 2.0, 1080p | $0.014 | $0.007678 | −45% |
| Seedance 2.0 Fast | $0.0112 | $0.005588 | −50% |
| Seedance 2.0 Mini | $0.007 | $0.003729 | −47% |
Vídeo facturado por segundo
| Modelo | fal.ai | TokLab | TokLab frente a fal |
|---|---|---|---|
| Grok Imagine Video 1.5, 480p | $0.08 | $0.04 | −50% |
| Grok Imagine Video 1.5, 720p | $0.14 | $0.08 | −43% |
| Veo 3.1 Fast, 1080p, audio | $0.15 | $0.1104 | −26% |
| Kling 4.0, 720p | $0.157 | $0.1425 | −9% |
| MiniMax H3 Max, 768p | $0.08 | $0.07313 | −9% |
| Veo 3.1, 1080p, audio | $0.40 | $0.368 | −8% |
En TokLab, las dos filas de Veo corresponden a veo-3.1-fast-official y veo-3.1-quality-official.
Imágenes
| Modelo | fal.ai | TokLab | TokLab frente a fal |
|---|---|---|---|
| Nano Banana 2.1, por 1 millón de tokens de salida de imagen | $35.294 | $19.50 | −45% |
| GPT Image 2.5, por 1 millón de tokens de salida de imagen | $30.00 | $22.50 | −25% |
| FLUX 3 Image Klein, 1K, por imagen | $0.009 | $0.00847 | −6% |
La diferencia es amplia en Seedance, Grok Imagine y Nano Banana, y pequeña en Kling, Veo 3.1 Quality y FLUX. Una plataforma que cuesta la mitad para un modelo puede estar a pocos puntos porcentuales en el siguiente. Por eso conviene calcular el coste de los dos o tres modelos que realmente usas.
En dos de las filas, TokLab tiene una ruta más barata que la que figura en la tabla. veo-3.1-fast cobra un precio fijo de $0.168 por clip de 8 segundos con resolución inferior a 4K, con menos opciones que el ID que factura por segundo (no permite activar o desactivar el audio). Y los ID con tarifa fija de GPT Image 2.5 cobran $0.021 por imagen tanto en calidad baja como media o alta: menos de la mitad de los $0.0528 de fal por una imagen de 1024×1024 en calidad alta.
En qué casos fal sale más barato ahora
fal tiene promociones para MiniMax H3. Del 1 al 15 de noviembre de 2026, su página de H3 Max aplica un 30% de descuento: $0.035 por segundo a 480p y $0.056 a 768p. TokLab cobra $0.0457 y $0.07313, por lo que fal sale un 23% más barato hasta que termine la promoción. A partir del 16 de noviembre, el precio de lista de fal vuelve a $0.05 y $0.08, y TokLab vuelve a estar un 9% por debajo. Con H3 Max Turbo ocurre lo mismo: $0.0175 y $0.028 en fal frente a $0.02285 y $0.03656 en TokLab.
GPT Image 2.5 en calidad baja es otro caso. La tarifa fija de $0.021 también se aplica a la calidad baja, mientras que la facturación por tokens de fal deja una imagen de 1024×1024 en calidad baja en $0.0060. Si generas muchos borradores pequeños y de baja calidad, la facturación por tokens de fal (o la ruta por tokens -official de TokLab, a $22.50 por millón de tokens de salida) cuesta menos que la tarifa fija.
Cuánto costaron cuatro solicitudes reales de Seedance
El 3 de noviembre de 2026 enviamos una solicitud de texto a vídeo a cada modelo Seedance en TokLab: 480p, 4:3 y 4 segundos, que se generan a 752×560. La pasarela facturó 39.891 tokens por solicitud, porque cuenta 97 fotogramas para 4 segundos, uno más que 4 × 24.
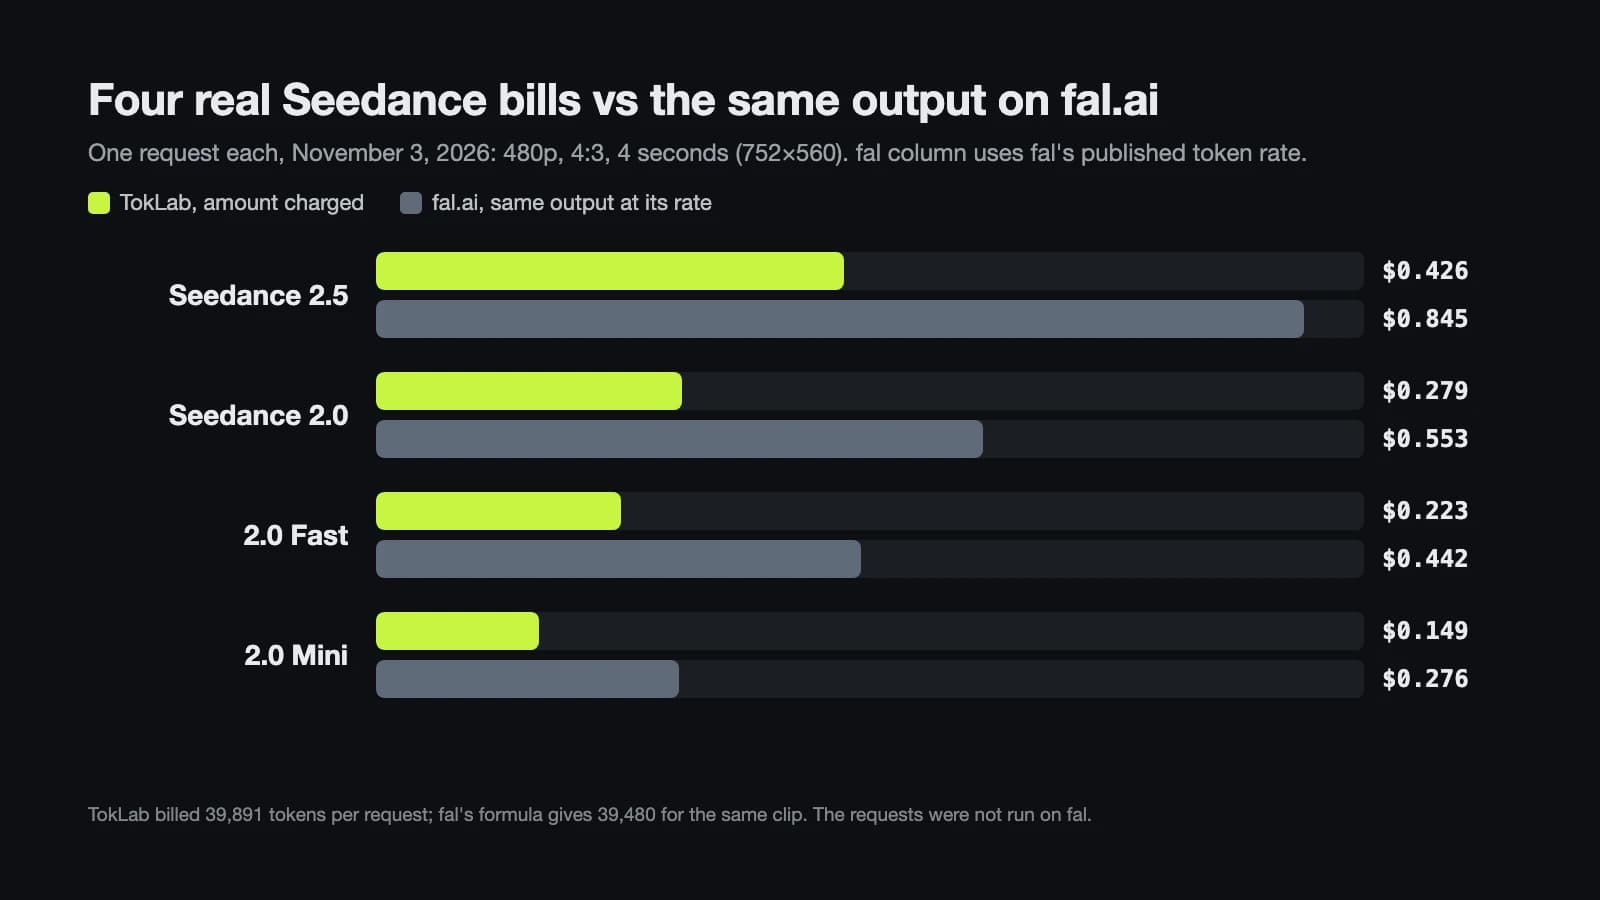
| Modelo | Cargo de TokLab | Mismo resultado con la tarifa de fal | Diferencia |
|---|---|---|---|
| Seedance 2.5 | $0.426076 | $0.8449 | −50% |
| Seedance 2.0 | $0.279078 | $0.5527 | −50% |
| Seedance 2.0 Fast | $0.222910 | $0.4422 | −50% |
| Seedance 2.0 Mini | $0.148754 | $0.2764 | −46% |
La columna de fal aplica su propia fórmula de tokens al mismo clip, que da 39.480 tokens, y la tarifa publicada de cada modelo. No ejecutamos estas solicitudes en fal. Cada cargo de TokLab se calculó como tokens × tarifa, redondeado al múltiplo de $0.000002 más cercano, el importe mínimo que factura el registro contable. Un clip de Mini de 5 segundos con los mismos ajustes facturó 49.761 tokens por $0.185558.
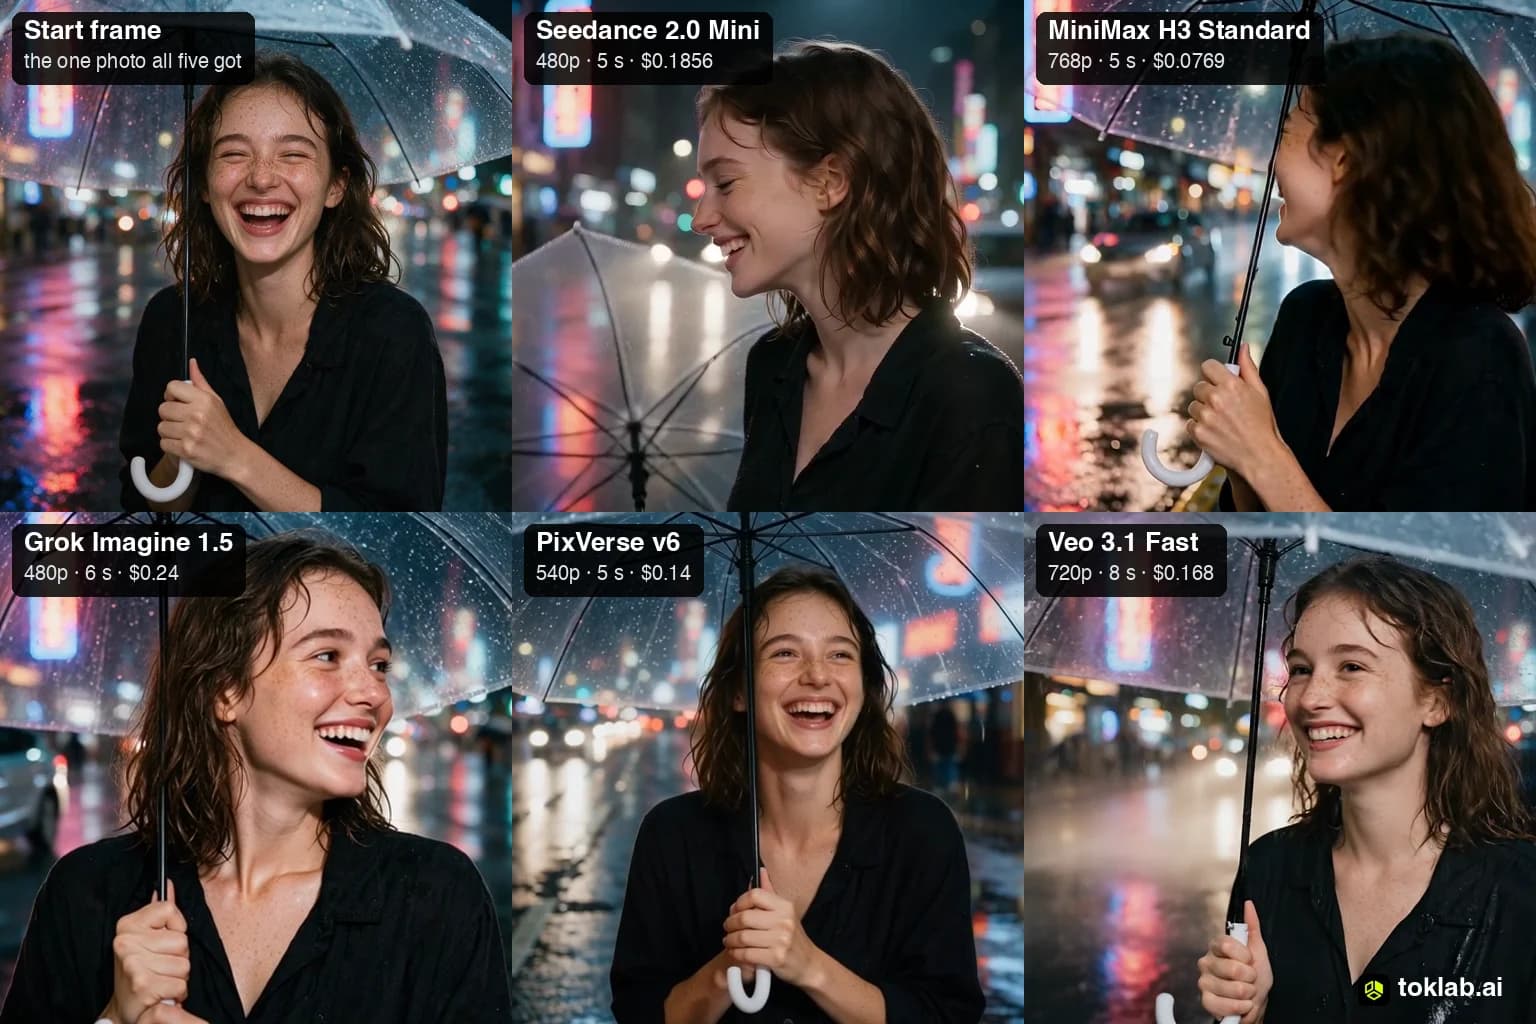
Repetimos las cuatro solicitudes el 4 de noviembre con otro prompt (los clips de la imagen del principio). Todas devolvieron 39.891 tokens y el mismo cargo que el día anterior. La factura depende de la resolución, la relación de aspecto y la duración, no del contenido de la imagen.
Las alternativas a fal.ai, una por una
TokLab
TokLab reúne modelos de imagen, vídeo, audio y texto en una sola API, con un saldo y una clave. Las tareas de vídeo e imagen se envían a /v1/videos/generations y /v1/images/generations, y se consultan en /v1/tasks/{id}; los modelos de texto usan /v1/chat/completions y /v1/responses, compatibles con OpenAI. Su página de modelos incluye 44 modelos, entre ellos Seedance 2.5 y 2.0, Kling, Veo 3.1, GPT Image 2.5, Nano Banana, Claude y GPT-6. Muchos ofrecen dos rutas: una con precio fijo por resultado y otra -official facturada por tokens.
El saldo no caduca, las tareas fallidas no se cobran y la recarga mínima es de $20.
Lo que falta también cuenta. No hay entrenamiento de LoRA, despliegue de modelos propios ni alquiler de GPU. Los resultados de las tareas se obtienen mediante consultas periódicas; la página de webhooks indica que las API de tareas «no ofrecen un webhook público de finalización». Y 44 modelos son una pequeña parte de los más de 1.500 de fal.
Ideal para: equipos que usan unos pocos modelos populares de vídeo e imagen a gran escala, buscan un menor precio por unidad para esos modelos y quieren acceder a los LLM con la misma clave.
Replicate
Replicate tiene el catálogo más amplio de este grupo. El 17 de noviembre de 2025, Cloudflare anunció que había acordado adquirir Replicate y citó más de 50.000 modelos listos para producción. Los modelos oficiales, como Seedance 2.0 Fast, se cobran por segundo de vídeo generado ($0.07 a 480p y $0.15 a 720p). Los modelos de la comunidad y tus propios despliegues se facturan por tiempo de uso del hardware; en su página de precios, una H100 cuesta $0.001525 por segundo, o $5.49 por hora.
Es la opción a la que acudir para encontrar un modelo ajustado para un nicho o uno de investigación que no aparece en los catálogos seleccionados. La contrapartida es que, al facturar el hardware por segundo, el coste de un modelo de la comunidad depende de cuánto tarde en ejecutarse.
Ideal para: proyectos que necesitan un modelo abierto concreto o quieren publicar el suyo.
Runware
Runware ejecuta los modelos en su propia infraestructura de inferencia y compite directamente con fal. Su página de comparación con fal enfrenta 63 modelos, afirma ofrecer un ahorro medio del 43% por modelo y un ahorro máximo del 92% en un modelo concreto (FLUX.1 [dev] SRPO, a $0.0019 frente a $0.025 por imagen). Son cifras de la propia Runware, y la página sirve para comprobar tu modelo antes de registrarte.
Ideal para: cargas de trabajo con muchas imágenes y modelos abiertos. Las variantes de FLUX y Qwen-Image ocupan la mayoría de los primeros puestos de su tabla de ahorro.
WaveSpeedAI
WaveSpeedAI aloja muchos de los mismos modelos de vídeo y fija sus precios por segundo según la resolución. En su página de modelo, Seedance 2.0 Fast cuesta $0.10 por segundo a 480p y $0.20 a 720p, con los totales calculados para 5, 10 y 15 segundos junto a cada tarifa. A 720p está un 17% por debajo de fal, una diferencia menor que la de Replicate, Runware o TokLab.
Ideal para: equipos de vídeo que quieren consultar los precios por segundo directamente en una tabla.
Together AI
Together AI es una plataforma de inferencia en la nube para modelos abiertos. Su página de precios empieza por los modelos de texto sin servidor y sigue con endpoints dedicados y alquiler de GPU: una HGX H100 cuesta $1.99 por hora de GPU en modalidad interrumpible o $3.99 bajo demanda. También incluye modelos multimedia, como Seedance 2.5 y 2.0, pero sus precios figuran como «por vídeo, estimado», lo que dificulta planificar el presupuesto de vídeo.
Ideal para: productos centrados en LLM que también necesitan algo de imagen o vídeo.
OpenRouter
OpenRouter permite acceder con una sola clave de API a modelos de texto de muchos proveedores y ahora también tiene una API asíncrona de generación de vídeo. Se encarga de dirigir las solicitudes: no aloja modelos, no los entrena ni alquila GPU. Los propios endpoints de chat de fal pasan por OpenRouter.
Ideal para: acceder a modelos de texto de muchos proveedores con una sola clave y una sola factura.
Alquilar GPU por tu cuenta
Si tu volumen de uso es constante, una GPU facturada por hora puede salir más barata que cualquier precio por resultado, porque pagas por la máquina y no por lo que genera. Las referencias son la H100 de fal (de $2.49 a $4.50 por hora), la de Together ($1.99 en modalidad interrumpible y $3.99 bajo demanda) y la de Replicate ($5.49). A cambio, tienes que encargarte de todo lo que resuelve una API alojada: cargar los pesos, gestionar los arranques en frío, escalar y mantener la máquina ocupada.
Cuándo conviene seguir en fal.ai
fal es la mejor opción si entrenas LoRA, despliegas modelos privados o ajustados, necesitas modelos 3D o de texto a voz (TokLab no ofrece ninguno de los dos), o dependes de su cola y sus webhooks. Su catálogo de más de 1.500 modelos también es difícil de igualar si cambias de modelo con frecuencia. Y hasta el 15 de noviembre de 2026, es la opción más barata para ejecutar MiniMax H3 Max y H3 Max Turbo.
Qué revisar antes de cambiar de plataforma
- Enumera los endpoints que usas y su volumen mensual. Calcula su coste en cada alternativa con la resolución y la duración que realmente necesitas. Ahorrar un 50% en un modelo que apenas usas vale menos que ahorrar un 9% en tu modelo principal.
- Relaciona los ID de modelo y adapta los cuerpos de las solicitudes. El
bytedance/seedance-2.0/fast/text-to-videode fal esdreamina-seedance-2-0-fasten TokLab, y el formato de solicitud cambia: Seedance en TokLab recibe el arraycontentde ByteDance. - Sustituye los webhooks si los usas. En TokLab consultas periódicamente
GET /v1/tasks/{id}hasta que el estado seacompletedofailed. - Comprueba cómo se cuentan los fotogramas. El vídeo facturado por tokens cuenta fotogramas, y puede haber una diferencia de un fotograma por clip entre proveedores. Supone alrededor de un 1% en un clip de 4 segundos, pero aparece al conciliar los cargos.
- Agota primero tu saldo de fal. Allí, el saldo comprado caduca a los 365 días de la compra.
Preguntas frecuentes
¿Hay alguna alternativa a fal.ai más barata para Seedance?
Sí. Las tarifas publicadas por token de Seedance en TokLab son aproximadamente la mitad de las de fal para 2.5, 2.0, Fast y Mini. Nuestras cuatro solicitudes de prueba del 3 de noviembre de 2026 costaron entre un 46% y un 50% menos que los mismos resultados calculados con las tarifas de fal. Replicate y Runware también publican precios de Seedance 2.0 Fast a 720p inferiores a los de fal.
¿fal.ai cobra por las solicitudes fallidas?
No. fal solo factura los resultados generados correctamente y no cobra las solicitudes que fallan por un error del servidor. TokLab funciona igual.
¿Caducan los créditos de fal.ai?
Sí. Según las condiciones de servicio de fal, los créditos comprados caducan a los 365 días de la compra, y los gratuitos o promocionales a los 90 días. El saldo de TokLab no caduca.
¿Replicate es más barato que fal.ai?
Depende del modelo. Seedance 2.0 Fast en Replicate cuesta $0.15 por segundo a 720p. En fal cuesta $0.2419. Para los modelos de la comunidad que se facturan por tiempo de GPU, el precio depende de cuánto tarde la ejecución, así que prueba con tus propias entradas.
¿Puedo usar una sola clave de API para LLM y vídeo?
En TokLab, sí: los modelos de texto usan los endpoints compatibles con OpenAI y los modelos multimedia usan los endpoints de tareas, todo con un mismo saldo. fal también ofrece modelos de chat, con las solicitudes dirigidas a través de OpenRouter.
Qué precios comparar para decidir
Para la mayoría de los equipos, la alternativa a fal.ai adecuada es la más barata para los dos o tres modelos que más usan. En la familia Seedance y en Grok Imagine Video, las tarifas de TokLab son entre un 43% y un 50% inferiores a las de fal. En Kling, Veo 3.1 Quality y FLUX, la diferencia es inferior al 10%, y en MiniMax H3 Max, fal sale más barato hasta el 15 de noviembre. Calcula el coste de tu carga de trabajo con las tablas anteriores y consulta las tarifas vigentes antes de trasladar el tráfico.